Prerrequisitos: tipos básicos, arreglos, punteros y modelo de memoria.
Objetivos: 1. Definir y acceder a campos de
structyunion. 2. Explicar cómo el padding puede afectar tamaño y portabilidad.Comprobación de salida: predecí qué campos comparten almacenamiento en una
uniony verificá el tamaño consizeof.
Estructuras y Tipos Compuestos
En C, las estructuras (struct), uniones (union) y campos de bits
(bit-fields) son las herramientas fundamentales que nos permiten ir más allá
de los tipos de datos básicos. Nos dan el poder de modelar entidades complejas
del mundo real, optimizar el uso de la memoria hasta el nivel del bit y
construir cualquier otra estructura de datos imaginable.
Primer recorrido verificable
Una estructura agrupa campos relacionados y permite acceder a ellos con ..
Antes de continuar, compilá y ejecutá este ejemplo mínimo:
1 2 3 4 5 6 7 8 9 10 11 12 13#include <stdio.h> typedef struct { char inicial; int legajo; } estudiante_t; int main(void) { estudiante_t estudiante = {.inicial = 'J', .legajo = 12345}; printf("%c %d\\n", estudiante.inicial, estudiante.legajo); return 0; }
gcc -std=c11 -Wall -Wextra -pedantic estudiante.c -o estudiante
./estudiante
La salida muestra dos ideas que usaremos durante todo el capítulo: cada campo conserva su tipo y la estructura se copia como un valor. Después agregaremos punteros, miembros dinámicos y padding; esos detalles se introducen solo cuando el ejemplo básico ya funciona.
Desarrollo
Los Ladrillos de la memoria
Estructuras (struct): Agrupando Datos
Una struct es una colección de variables (miembros) de diferentes tipos,
agrupadas bajo un solo nombre.
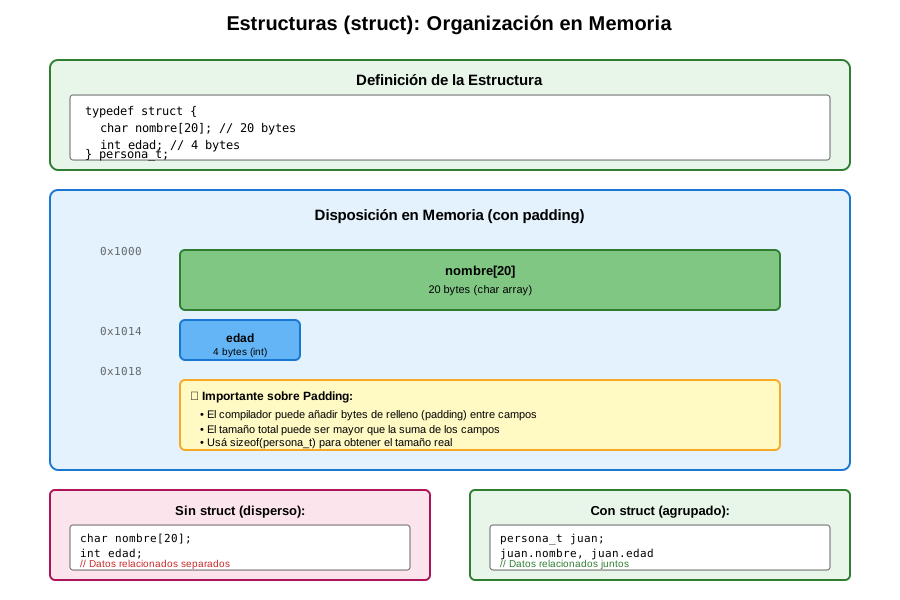
Figure 1:Las estructuras agrupan datos relacionados en memoria. El compilador puede añadir padding entre campos para optimizar el acceso.
Declaración y typedef
La práctica estándar, como indica la regla 0x3004h: Utilizá typedef para definir tipos de estructuras con el sufijo _t, es usar typedef
para crear un alias de tipo con el sufijo _t.
1 2 3 4 5 6 7 8typedef struct { char inicial; int legajo; float promedio; } estudiante_t; // Inicialización con inicializadores designados (preferido) estudiante_t estudiante1 = {.inicial = 'J', .legajo = 12345, .promedio = 8.5f};
Acceso a Miembros: . vs ->
Operador Punto (
.): Para acceder a miembros de una variablestruct.Operador Flecha (
->): Para acceder a miembros a través de un puntero a unastruct.
1 2 3 4estudiante_t est; estudiante_t *p_est = &est; est.legajo = 54321; // Acceso directo p_est->promedio = 9.0f; // Acceso mediante puntero
El acceso -> es equivalente a usar (*p_est).promedio, se prefiere la flecha
para simplificar este uso.
Estructuras y Memoria: Alineación y Relleno (Padding)
El compilador de C puede insertar bytes de relleno invisibles (denominados
padding) entre los miembros de un struct para cumplir las restricciones de
alineación de la implementación. La alineación no está definida universalmente
como “múltiplo del tamaño”: depende del tipo, la plataforma y el ABI.
La razón habitual es permitir accesos eficientes en una arquitectura concreta. El costo de un acceso desalineado depende de la CPU: puede ser más lento, estar permitido sin costo apreciable o generar una excepción. No debe deducirse una cantidad fija de transferencias de memoria solamente a partir de C.
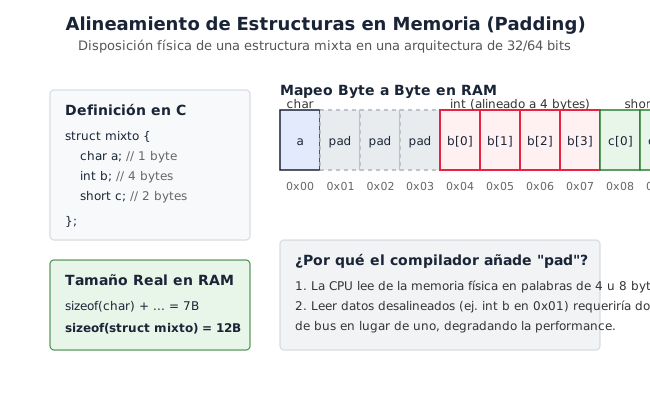
Figure 2:Disposición física de una estructura mixta en RAM. El compilador inserta bytes
de relleno (pad) para garantizar que el entero b inicie en una dirección
múltiplo de 4, incrementando el sizeof total de 7 a 12 bytes.
El problema con esto es que en algunos casos (como en protocolos de red o controladores de hardware) necesitamos un control exacto de los bits y de la disposición exacta en memoria de cada byte de la estructura.
El “operador” offsetof
offsetof es una macro definida en el archivo de cabecera <stddef.h>. Su
propósito es calcular el desplazamiento en bytes de un miembro específico
dentro de una estructura (struct) o unión (union), desde el inicio de la
misma.
En otras palabras, te dice cuántos bytes hay entre el comienzo de la estructura y el comienzo de uno de sus miembros.
¿Para qué sirve?
Su principal utilidad reside en situaciones donde necesitas conocer la posición exacta de un miembro dentro de una estructura sin tener una instancia de esa estructura. Esto es común en programación de bajo nivel, serialización de datos y al trabajar con buffers de memoria genéricos.
Sintaxis
La sintaxis es la siguiente:
1offsetof(type, member)
type: Es el nombre del tipo de la estructura (ej.struct MiEstructura).member: Es el nombre del miembro de la estructura del cual querés saber el desplazamiento.
La macro devuelve un valor de tipo size_t, que es un tipo entero sin signo
capaz de representar el tamaño de cualquier objeto en memoria.
Ejemplo Práctico
Imagina que tienes la siguiente estructura:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18#include <stddef.h> #include <stdio.h> struct Usuario { int id; char inicial; double salario; }; int main() { size_t desplazamiento_id = offsetof(struct Usuario, id); size_t desplazamiento_inicial = offsetof(struct Usuario, inicial); size_t desplazamiento_salario = offsetof(struct Usuario, salario); printf("Desplazamiento de 'id': %zu bytes\n", desplazamiento_id); printf("Desplazamiento de 'inicial': %zu bytes\n", desplazamiento_inicial); printf("Desplazamiento de 'salario': %zu bytes\n", desplazamiento_salario); return 0; }
Posible Salida
La salida de este código podría ser:
Desplazamiento de 'id': 0 bytes
Desplazamiento de 'inicial': 4 bytes
Desplazamiento de 'salario': 8 bytes
¿Qué nos dice esta salida?
id: Está al puro inicio de la estructura, por lo que su desplazamiento es 0.inicial: Comienza en el byte 4. Esto se debe a que elint(id) ocupa 4 bytes, y el compilador puede añadir relleno (padding) para alinear los datos en memoria y optimizar el acceso.salario: Empieza en el byte 8. Después delchar(inicial), que ocupa 1 byte, el compilador ha añadido 3 bytes de relleno antes desalariopara que estedouble(que suele ocupar 8 bytes) comience en una dirección de memoria múltiplo de 8, lo cual es más eficiente para el procesador.
Casos de Uso Comunes
Cálculos de Punteros: Es fundamental en la “aritmética de punteros” avanzada. Por ejemplo, si tienes un puntero a un miembro de una estructura y quieres obtener un puntero a la estructura contenedora completa. Una macro común para esto es
container_ofen el kernel de Linux, que depende internamente deoffsetof.Serialización/Deserialización: Cuando necesitas guardar una estructura en un archivo o enviarla a través de una red, a menudo se convierte a un arreglo de bytes.
offsetofayuda a saber dónde empieza cada campo en ese buffer de bytes.Interfaces con otros lenguajes: Al interactuar con código ensamblador u otros lenguajes de bajo nivel, a veces necesitas pasar la ubicación exacta de los campos de una estructura.
En resumen, offsetof es una herramienta poderosa y necesaria en la
programación de sistemas en C para manipular la memoria a un nivel muy preciso,
permitiendo interactuar directamente con la disposición de los datos en las
estructuras.
Laboratorio 1: Inspección de Layout
Vamos a analizar el layout de una estructura para visualizar el padding.
layout_inspect.c
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17#include <stddef.h> #include <stdio.h> typedef struct { char a; // 1 byte int b; // 4 bytes char c; // 1 byte } ejemplo_padding_t; int main(void) { printf("sizeof(char) = %zu, sizeof(int) = %zu\n", sizeof(char), sizeof(int)); printf("sizeof(ejemplo_padding_t) = %zu\n\n", sizeof(ejemplo_padding_t)); printf("offsetof(a) = %zu\n", offsetof(ejemplo_padding_t, a)); printf("offsetof(b) = %zu\n", offsetof(ejemplo_padding_t, b)); printf("offsetof(c) = %zu\n", offsetof(ejemplo_padding_t, c)); }
Compilación y Ejecución:
gcc -Wextra -Wall -g layout_inspect.c -o layout_inspect
./layout_inspect
Salida Esperada:
sizeof(char) = 1, sizeof(int) = 4
sizeof(ejemplo_padding_t) = 12

offsetof(a) = 0
offsetof(b) = 4
offsetof(c) = 8
Análisis:
El tamaño total es 12 bytes, no 6 (1+4+1).
bestá en el offset 4, no 1. El compilador insertó 3 bytes de padding después dea.cestá en el offset 8.Se añaden 3 bytes de padding al final para que el tamaño total (12) sea múltiplo del miembro más grande (4), asegurando la alineación en arreglos.
Solution to Exercise 1
El orden óptimo es ordenar los miembros de mayor a menor tamaño: int b; char a; char c;.
1 2 3 4 5 6 7 8typedef struct { int b; // 4 bytes char a; // 1 byte char c; // 1 byte // 2 bytes de padding al final para alinear la estructura completa } ejemplo_optimizado_t; // sizeof será 8
Aunque el orden char a; char c; int b; también reduce el tamaño a 8 bytes, la
regla generalizable y recomendada para estructuras con múltiples tipos complejos
es ordenar los miembros siempre de mayor a menor tamaño. Esto minimiza el
padding de alineación de forma consistente sin importar la cantidad o el tipo de
los datos adicionales, como se detalla en la Regla de Oro.
Documentación de Estructuras
La documentación clara y detallada de las estructuras es fundamental para mantener código comprensible y mantenible. Una buena documentación explica no solo qué es cada campo, sino también su propósito, restricciones y relaciones con otros miembros. Existen dos enfoques principales para documentar estructuras, cada uno con sus ventajas según el contexto.
Enfoque 1: Bloque de Documentación Único
Este enfoque utiliza un único bloque de comentario antes de la definición de la estructura para describir su propósito general y documentar todos sus miembros. Es ideal para estructuras simples o cuando los miembros requieren explicaciones breves.
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18/** * Representa un punto en el espacio tridimensional. * * Esta estructura almacena las coordenadas cartesianas (x, y, z) * de un punto en el espacio 3D. Todas las coordenadas se expresan * en unidades del sistema internacional (metros). * * Miembros: * - x: Coordenada en el eje X (horizontal) * - y: Coordenada en el eje Y (profundidad) * - z: Coordenada en el eje Z (altura) */ typedef struct { double x; double y; double z; } punto_3d_t;
Ventajas:
Proporciona una visión general cohesiva de la estructura.
Facilita la explicación de relaciones entre miembros.
Mantiene la definición de la estructura visualmente limpia.
Desventajas:
Puede volverse difícil de mantener si la estructura crece.
La separación entre documentación y código puede dificultar actualizaciones.
Enfoque 2: Documentación Distribuida
Este enfoque combina un bloque de comentario que describe el propósito general de la estructura con comentarios de línea individuales para cada miembro. Es preferible para estructuras complejas con muchos campos o cuando cada miembro requiere explicación detallada.
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26#include <stdbool.h> #include <time.h> enum tipo_transaccion { TRANSFERENCIA, DEPOSITO, RETIRO }; /** * Representa la configuración de una conexión de red. * * Esta estructura almacena todos los parámetros necesarios para * establecer y mantener una conexión de red TCP/IP. Los valores * deben ser inicializados antes de llamar a conectar_red(). */ typedef struct { char direccion_ip[16]; // Dirección IP en formato "xxx.xxx.xxx.xxx" unsigned short puerto; // Puerto de destino (1-65535) int timeout_ms; // Tiempo de espera en milisegundos para la bool usar_tls; // true si se requiere conexión segura (TLS/SSL) unsigned int reintentos; // Número máximo de intentos de reconexión void *contexto_usuario; // Puntero opaco para datos del usuario; puede ser NULL } configuracion_red_t;
Ventajas:
Cada campo tiene su documentación adyacente, facilitando actualizaciones.
La estructura es autodocumentada al leerla linealmente.
Ideal para estructuras con campos que requieren explicaciones específicas.
Desventajas:
Puede hacer la definición visualmente más extensa.
Las relaciones entre campos pueden ser menos evidentes.
Ejemplo Completo: Estructura Compleja
Para estructuras complejas que involucran múltiples conceptos, el enfoque distribuido suele ser más efectivo:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26/** * Representa el estado completo de una transacción bancaria. * * Esta estructura almacena toda la información necesaria para * procesar, validar y auditar una transacción financiera. * Todos los montos están expresados en la menor unidad de la * moneda (centavos para ARS, USD, etc.). * * Invariantes: * - monto debe ser > 0 * - numero_cuenta_origen y numero_cuenta_destino deben ser distintos * - timestamp debe ser válido (verificar con validar_timestamp()) */ typedef struct { char id_transaccion[37]; // UUID único de la transacción (formato RFC 4122) long long monto; // Monto en la menor unidad de la moneda char numero_cuenta_origen[21]; // Máx. 20 dígitos + '\0' char numero_cuenta_destino[21]; // Máx. 20 dígitos + '\0' time_t timestamp; // Momento de la transacción enum tipo_transaccion tipo; // Tipo de operación char descripcion[256]; // Descripción proporcionada por el usuario bool procesada; // true si la transacción ya fue procesada int codigo_resultado; // 0 = éxito, != 0 = código de error char firma_digital[65]; // Hash SHA-256 en hexadecimal + '\0' } transaccion_bancaria_t;
Recomendaciones Generales
Consistencia: Elegí un enfoque y mantenélo en todo el proyecto. Si usás el enfoque distribuido, todos los miembros deben tener comentarios.
Información Útil: Documentá restricciones, rangos válidos, unidades de medida y valores especiales (como NULL para punteros opcionales).
Invariantes: Si la estructura tiene invariantes o precondiciones, documentalas claramente en el bloque general.
Actualizaciones: Cuando modifiques la estructura, actualizá la documentación inmediatamente. La documentación desactualizada es peor que la falta de documentación.
Relaciones: Si los campos tienen dependencias entre sí, explicá estas relaciones claramente.
Para más detalles sobre el estilo de comentarios y documentación, consultá la regla 0x0201h: Escribí comentarios que expliquen el ‘porqué’, no el ‘qué’ sobre cómo escribir comentarios que expliquen el “porqué” y no el “qué”.
punteros en Estructuras
Cuando una estructura (struct) contiene punteros en otros datos, debemos
gestionar la memoria en múltiples niveles. Como vimos en
El Montón (Heap), cada llamada a malloc reserva memoria en el heap que
debe ser liberada explícitamente. Con estructuras anidadas, este principio se
aplica recursivamente.
Creación de Estructuras Dinámicas
Para crear una instancia de una estructura que contiene punteros (como char* nombre), se requieren múltiples asignaciones de memoria. Consideremos una
estructura persona_t:
#include <stdlib.h>
#include <string.h>

typedef struct
{
    char *nombre;
    int edad;
} persona_t;
El proceso de creación involucra tres pasos fundamentales:
Paso 1: Asignar la Estructura Contenedora
Primero, reservamos memoria para la estructura en sí:
1 2 3 4 5 6persona_t *nuevo = malloc(sizeof *nuevo); if (nuevo == NULL) { // Manejar error de asignación return NULL; }
Paso 2: Asignar Miembros Internos
Luego, reservamos memoria para cada puntero dentro de la estructura:
1 2 3 4 5 6 7// +1 para el carácter nulo '\0' nuevo->nombre = malloc(sizeof(char) * (strlen(nombre) + 1)); if (nuevo->nombre == NULL) { free(nuevo); // Liberar lo ya asignado return NULL; }
Paso 3: Copiar Datos
Finalmente, copiamos los datos a la memoria recién asignada:
1 2strcpy(nuevo->nombre, nombre); nuevo->edad = edad;
Operador Flecha (->)
El operador -> es un atajo sintáctico para acceder a miembros de una
estructura a través de un puntero. Como se explica en Punteros,
este operador combina la desreferencia y el acceso a
miembro en una sola operación.
Equivalencia:
1puntero->miembro ≡ (*puntero).miembro
Ejemplo comparativo:
1 2 3 4 5 6 7persona_t *p = /* ... */; // Usando -> p->edad = 30; p->nombre[0] = 'J'; // Equivalente sin -> (*p).edad = 30; (*p).nombre[0] = 'J';
La notación con -> es más legible y es la forma idiomática en C para
trabajar con punteros en estructuras.
Destrucción de Estructuras Dinámicas
La liberación de memoria debe seguir el orden inverso al de la creación. Este patrón se conoce como “de adentro hacia afuera” o LIFO (Last In, First Out).
Orden Correcto de Liberación
1 2 3 4 5 6 7 8 9 10 11 12void persona_destruir(persona_t **persona_out) { if (persona_out == NULL || *persona_out == NULL) { return; // Nada que hacer } // 1. Liberar miembros internos primero free((*persona_out)->nombre); // 2. Liberar la estructura contenedora free(*persona_out); *persona_out = NULL; }
¿Por Qué Este Orden?
Si liberás persona primero, perdés el puntero a persona->nombre. Una vez
que free(persona) se ejecuta, acceder a persona->nombre es comportamiento
indefinido (ver Dangling Pointer (Puntero Colgante)). Esto resulta en un
memory leak porque la memoria de nombre queda asignada pero inaccesible.
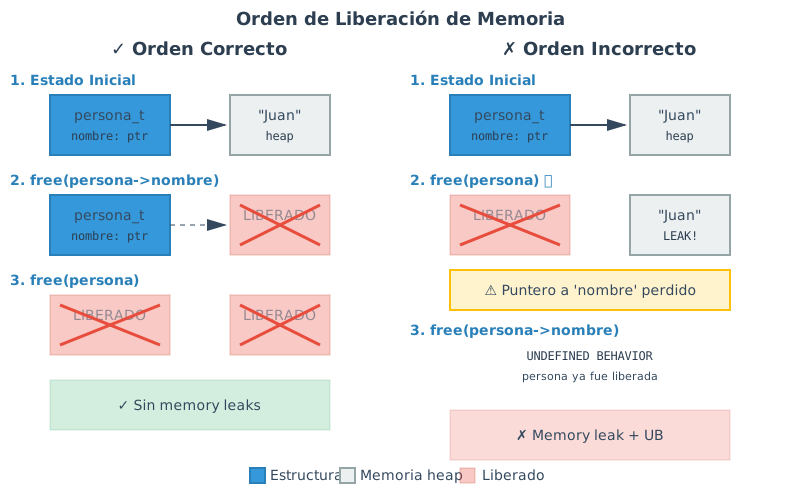
Figure 3:Orden correcto vs incorrecto de liberación de memoria en estructuras anidadas.
Generalización: Estructuras con Múltiples Punteros
Para estructuras con varios niveles de punteros, aplicá el mismo principio recursivamente:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15typedef struct { char *nombre; char *apellido; int *calificaciones; // Array dinámico } estudiante_t; void estudiante_destruir(estudiante_t *est) { if (est == NULL) return; free(est->calificaciones); // Nivel más profundo primero free(est->apellido); free(est->nombre); free(est); // Contenedor al final }
Ejercicios de Autoevaluación (punteros en Estructuras)
Diseñá persona_crear y persona_destruir para una estructura que contiene
char *nombre reservado dinámicamente. La destrucción debe ser segura si la
creación falla a mitad de camino.
Solución orientativa
typedef struct { char *nombre; } persona_t;

void persona_destruir(persona_t **pp)
{
    if (pp == NULL || *pp == NULL) return;
    free((*pp)->nombre);
    free(*pp);
    *pp = NULL;
}
La creación reserva primero el contenedor y luego una copia del nombre; ante
cualquier error llama a persona_destruir y no deja una propiedad parcial. El
parámetro doble permite invalidar también el puntero del llamador.
Consideraciones de Uso y Diseño
El diseño de estructuras va más allá de simplemente agrupar datos relacionados. Las decisiones sobre cómo organizar los miembros impactan directamente en la claridad del código, el rendimiento, la mantenibilidad y la corrección del programa. Esta sección explora principios y patrones de diseño fundamentales para crear estructuras efectivas.
Arreglo de Estructuras vs Estructura de Arreglos
Una de las decisiones más importantes al diseñar estructuras es elegir entre arreglo de estructuras (AoS) o estructura de arreglos (SoA). Ambos enfoques tienen trade-offs significativos en términos de claridad, rendimiento y facilidad de uso.
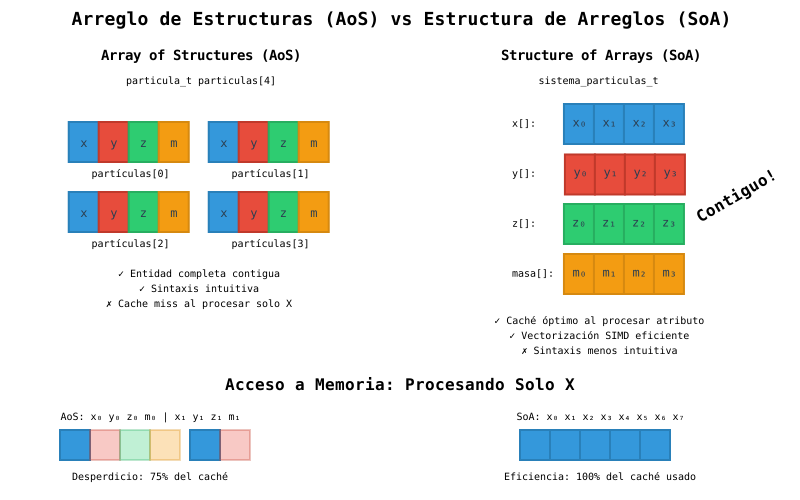
Figure 4:Comparación visual entre AoS y SoA mostrando cómo se organizan los datos en memoria y el impacto en el uso de caché.
Arreglo de Estructuras (Array of Structures - AoS)
En este enfoque, cada elemento del arreglo es una estructura completa que contiene todos los atributos de una entidad.
1 2 3 4 5 6 7 8 9 10 11 12typedef struct { double x; double y; double z; double masa; double velocidad_x; double velocidad_y; double velocidad_z; } particula_t; // Arreglo de 1000 partículas particula_t particulas[1000];
Ventajas:
Claridad conceptual: Cada elemento del arreglo representa una entidad completa e independiente.
Facilidad de uso: Acceder a todos los atributos de una partícula es intuitivo:
particulas[i].x,particulas[i].y, etc.Gestión de memoria simple: Una sola asignación para todo el arreglo.
Localidad espacial por entidad: Todos los datos de una entidad están contiguos en memoria.
Ideal para operaciones por entidad: Si procesás cada entidad individualmente con todos sus atributos.
Desventajas:
Caché poco eficiente en operaciones vectoriales: Si solo necesitás un atributo (ej: solo las posiciones
x), el procesador carga en caché datos innecesarios (masa, velocidades, etc.).Penalización en SIMD: Las instrucciones vectoriales modernas (SSE, AVX) prefieren datos contiguos del mismo tipo.
Ejemplo de Uso:
1 2 3 4 5 6 7 8 9 10void actualizar_posiciones_aos(particula_t particulas[], size_t n, double dt) { for (size_t i = 0; i < n; i++) { // Acceso intuitivo, todos los datos de una partícula juntos particulas[i].x += particulas[i].velocidad_x * dt; particulas[i].y += particulas[i].velocidad_y * dt; particulas[i].z += particulas[i].velocidad_z * dt; } }
Estructura de Arreglos (Structure of Arrays - SoA)
En este enfoque, cada atributo se almacena en su propio arreglo, y la estructura contiene estos arreglos.
1 2 3 4 5 6 7 8 9 10 11 12typedef struct { double *x; double *y; double *z; double *masa; double *velocidad_x; double *velocidad_y; double *velocidad_z; size_t cantidad; size_t capacidad; } sistema_particulas_t;
Ventajas:
Eficiencia de caché: Al procesar un solo atributo (ej: todas las posiciones
x), accedés a memoria contigua sin datos irrelevantes.Optimización SIMD: Procesadores modernos pueden aplicar la misma operación a múltiples elementos simultáneamente.
Menos desperdicio de ancho de banda: Solo cargás los datos que realmente necesitás.
Desventajas:
Complejidad de gestión: Múltiples asignaciones de memoria, más propenso a errores.
Sintaxis menos intuitiva:
sistema.x[i]vsparticulas[i].x.Consistencia manual: Debés garantizar que todos los arreglos tengan el mismo tamaño.
Mayor overhead en operaciones por entidad: Si necesitás todos los atributos de una entidad, accedés a múltiples arreglos.
Ejemplo de Uso:
1 2 3 4 5 6 7 8 9 10void actualizar_posiciones_soa(sistema_particulas_t *sistema, double dt) { // Acceso optimizado para procesamiento vectorial for (size_t i = 0; i < sistema->cantidad; i++) { sistema->x[i] += sistema->velocidad_x[i] * dt; sistema->y[i] += sistema->velocidad_y[i] * dt; sistema->z[i] += sistema->velocidad_z[i] * dt; } }
Este código es más fácil de vectorizar automáticamente por el compilador, ya que cada lazo procesa un arreglo contiguo de un solo tipo.
Ninguna representación es universalmente superior: la elección debe basarse en
el patrón de acceso dominante y un perfilado reproducible, no en la intuición.
Si el acceso típico actualiza la partícula completa, AoS gana en localidad; si
el acceso típico recorre un solo atributo de todas las partículas (por ejemplo,
sumar todas las x), SoA evita traer a caché campos que no se usan.
Mini-ejercicio
Implementá una operación que sume una única componente (por ejemplo x) de
N partículas, una vez en AoS y otra en SoA, y medí el tiempo con el
compilador optimizando (-O2) para N grande. ¿La diferencia observada es
consistente con la localidad esperada? Documentá CPU, compilador y N antes
de generalizar.
Implementación Completa: Gestión de Memoria en SoA
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53sistema_particulas_t *crear_sistema(size_t capacidad_inicial) { sistema_particulas_t *sistema = NULL; sistema = malloc(sizeof(sistema_particulas_t)); if (sistema == NULL) { return NULL; } // Asignación de cada arreglo individual sistema->x = malloc(capacidad_inicial * sizeof(double)); sistema->y = malloc(capacidad_inicial * sizeof(double)); sistema->z = malloc(capacidad_inicial * sizeof(double)); sistema->masa = malloc(capacidad_inicial * sizeof(double)); sistema->velocidad_x = malloc(capacidad_inicial * sizeof(double)); sistema->velocidad_y = malloc(capacidad_inicial * sizeof(double)); sistema->velocidad_z = malloc(capacidad_inicial * sizeof(double)); // Verificación exhaustiva if (sistema->x == NULL || sistema->y == NULL || sistema->z == NULL || sistema->masa == NULL || sistema->velocidad_x == NULL || sistema->velocidad_y == NULL || sistema->velocidad_z == NULL) { // Liberar todo lo asignado antes del error free(sistema->x); free(sistema->y); free(sistema->z); free(sistema->masa); free(sistema->velocidad_x); free(sistema->velocidad_y); free(sistema->velocidad_z); free(sistema); return NULL; } sistema->cantidad = 0; sistema->capacidad = capacidad_inicial; return sistema; } void destruir_sistema(sistema_particulas_t *sistema) { if (sistema == NULL) { return; } // Liberar cada arreglo free(sistema->x); free(sistema->y); free(sistema->z); free(sistema->masa); free(sistema->velocidad_x); free(sistema->velocidad_y); free(sistema->velocidad_z); // Finalmente la estructura principal free(sistema); }
¿Cuándo Usar Cada Enfoque?
Usá Arreglo de Estructuras (AoS) cuando:
La claridad y simplicidad del código es prioritaria
Procesás entidades completas de forma individual
Las estructuras no son extremadamente grandes
No hay cuellos de botella de rendimiento identificados
El código es más legible y mantenible para tu equipo
Usá Estructura de Arreglos (SoA) cuando:
El rendimiento es crítico y hay análisis de perfilado que lo justifica
Procesás frecuentemente un solo atributo de muchas entidades
Trabajás con procesamiento masivo de datos (física, gráficos, simulaciones)
Querés aprovechar instrucciones SIMD del procesador
El dominio del problema es naturalmente “columnar”
Ejemplo Comparativo: Búsqueda de Máximo
AoS:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17// Encontrar la partícula con mayor masa particula_t *encontrar_mas_masiva_aos(particula_t particulas[], size_t n) { if (n == 0) { return NULL; } particula_t *mas_masiva = &particulas[0]; for (size_t i = 1; i < n; i++) { if (particulas[i].masa > mas_masiva->masa) { mas_masiva = &particulas[i]; } } return mas_masiva; }
SoA:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20// Encontrar el índice de la partícula con mayor masa size_t encontrar_mas_masiva_soa(const sistema_particulas_t *sistema) { if (sistema->cantidad == 0) { return SIZE_MAX; // Indicador de error } size_t indice_max = 0; double masa_max = sistema->masa[0]; // Acceso contiguo a memoria, ideal para vectorización for (size_t i = 1; i < sistema->cantidad; i++) { if (sistema->masa[i] > masa_max) { masa_max = sistema->masa[i]; indice_max = i; } } return indice_max; }
En el caso de SoA, el lazo accede únicamente al arreglo masa, lo cual es
óptimo para el caché. Sin embargo, notá que la función retorna un índice, no un
puntero, lo que puede ser menos conveniente para el usuario.
Encapsulación de Invariantes
Las estructuras deben diseñarse de modo que sea imposible o difícil crear instancias inválidas. Esto se logra mediante:
Constructores: Funciones que inicializan correctamente la estructura.
Validadores: Funciones que verifican invariantes.
Punteros opacos: Ocultar la implementación interna.
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39/** * Representa un rectángulo con lados paralelos a los ejes. * * Invariantes: * - ancho debe ser > 0 * - alto debe ser > 0 */ typedef struct { double x; // Coordenada X de la esquina inferior izquierda double y; // Coordenada Y de la esquina inferior izquierda double ancho; // Ancho del rectángulo (debe ser > 0) double alto; // Alto del rectángulo (debe ser > 0) } rectangulo_t; // Constructor que garantiza invariantes rectangulo_t crear_rectangulo(double x, double y, double ancho, double alto) { rectangulo_t rect = {0}; // Validación de precondiciones if (ancho <= 0.0 || alto <= 0.0) { fprintf(stderr, "Error: dimensiones de rectángulo deben ser positivas\n"); rect.ancho = 1.0; // Valores seguros por defecto rect.alto = 1.0; } else { rect.x = x; rect.y = y; rect.ancho = ancho; rect.alto = alto; } return rect; } bool es_rectangulo_valido(const rectangulo_t *rect) { return rect != NULL && rect->ancho > 0.0 && rect->alto > 0.0; }
Minimización de Padding
Ordenar los miembros de mayor a menor tamaño reduce el padding y el tamaño total de la estructura:
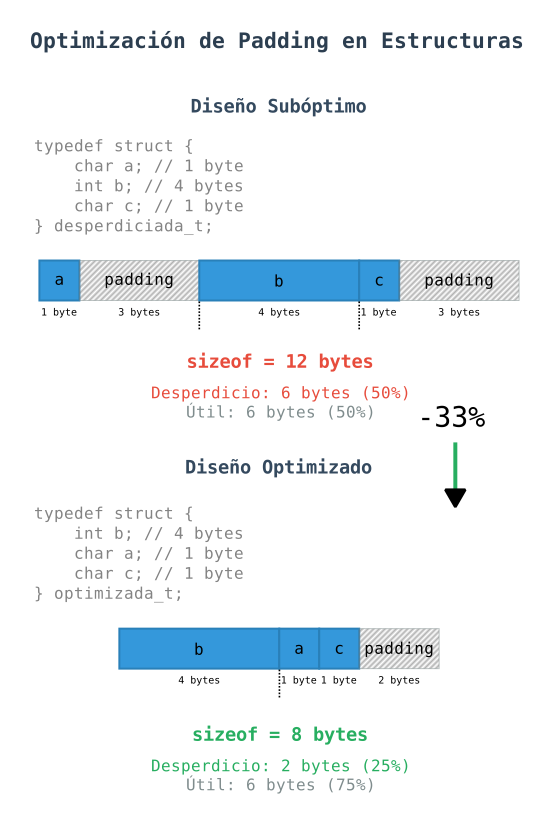
Figure 5:Optimización de estructuras ordenando miembros por tamaño. El diseño subóptimo desperdicia 50% del espacio, mientras que el optimizado solo 25%.
1 2 3 4 5 6 7 8 9 10 11// Diseño subóptimo (12 bytes en x86-64) - Equivalente a ejemplo_padding_t del Laboratorio 1 // (Ver offsetof y padding detallados en el Laboratorio 1) // Diseño optimizado (8 bytes en x86-64) - Aplicando la regla de // ordenamiento mayor a menor typedef struct { int b; // 4 bytes char a; // 1 byte char c; // 1 byte (2 bytes de padding después) } optimizada_t;
Uso de Estructuras Anidadas
Las estructuras anidadas permiten organizar conceptos complejos de forma jerárquica:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20typedef struct { double x; double y; } punto_2d_t; typedef struct { punto_2d_t posicion; punto_2d_t velocidad; double masa; double radio; } cuerpo_2d_t; // Uso cuerpo_2d_t planeta = {.posicion = {.x = 0.0, .y = 0.0}, .velocidad = {.x = 10.0, .y = 5.0}, .masa = 5.97e24, .radio = 6.371e6}; // Acceso double distancia_al_origen = sqrt(planeta.posicion.x * planeta.posicion.x + planeta.posicion.y * planeta.posicion.y);
Ventajas:
Reutilización de tipos comunes (
punto_2d_tusado para posición y velocidad)Organización lógica clara
Facilita la creación de funciones genéricas (ej:
calcular_distanciaque opera sobrepunto_2d_t)
Estructuras Auto-descriptivas
Incluir metadatos en la estructura facilita la depuración y la serialización:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31typedef enum { TIPO_ENTERO, TIPO_FLOTANTE, TIPO_CADENA } tipo_dato_t; typedef struct { tipo_dato_t tipo; union { int entero; double flotante; char *cadena; } valor; } dato_generico_t; void imprimir_dato(const dato_generico_t *dato) { switch (dato->tipo) { case TIPO_ENTERO: printf("Entero: %d\n", dato->valor.entero); break; case TIPO_FLOTANTE: printf("Flotante: %.2f\n", dato->valor.flotante); break; case TIPO_CADENA: printf("Cadena: %s\n", dato->valor.cadena); break; } }
Este patrón (estructura con un enum que indica el tipo y un union que
contiene los datos) se llama tagged union y es fundamental para representar
datos heterogéneos de forma segura.
Uniones (union): Un Espacio para Múltiples Propósitos
La introducción breve puede leerse después de struct; los casos de tagged
unions y reinterpretación de bytes se relacionan con
Cast Aritmético vs. Cast de Reinterpretación en 9_casts.md.
Una union permite que varios miembros compartan la misma región de
almacenamiento. Su tamaño es, como mínimo, el del miembro más grande y puede
incluir padding para cumplir la alineación. En el diseño habitual se mantiene
una etiqueta que indica qué interpretación debe usar el programa.
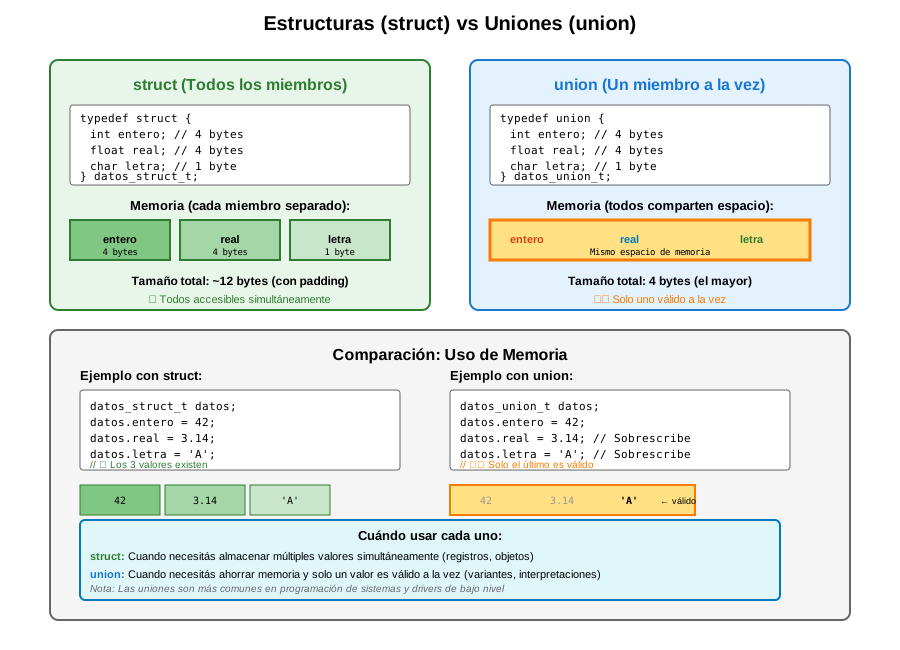
Figure 6:Comparación visual entre estructuras (todos los miembros en memoria separada) y uniones (todos comparten el mismo espacio de memoria).
El Patrón de Unión Etiquetada (Tagged Union)
Por sí mismas, las union tienen usos muy limitados ya que no es posible saber
como tenemos que interpretar la información contenida, para esto, se utiliza una
unión etiquetada: una struct que contiene un enum (la etiqueta) y una
union (el valor).
tagged_union.c
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42#include <stdio.h> typedef enum { TIPO_INT, TIPO_FLOAT, TIPO_TEXTO } tipo_dato_t; typedef struct { tipo_dato_t tipo; union { int i; float f; const char *s; } valor; } variante_t; void imprimir_variante(const variante_t *v) { switch (v->tipo) { case TIPO_INT: printf("Entero: %d\n", v->valor.i); break; case TIPO_FLOAT: printf("Flotante: %.2f\n", v->valor.f); break; case TIPO_TEXTO: printf("Texto: \"%s\"\n", v->valor.s); break; } } int main() { variante_t v1 = {.tipo = TIPO_INT, .valor.i = 100}; variante_t v2 = {.tipo = TIPO_FLOAT, .valor.f = 3.14f}; variante_t v3 = {.tipo = TIPO_TEXTO, .valor.s = "Hola"}; imprimir_variante(&v1); imprimir_variante(&v2); imprimir_variante(&v3); return 0; }
Este patrón es la base para implementar tipos de datos polimórficos en C.
Documentación de Uniones
Las uniones (union) requieren documentación particularmente cuidadosa debido a
que múltiples miembros comparten la misma región de almacenamiento. El acceso a
un miembro distinto del que representa el estado actual puede ser dependiente de
la implementación o producir una representación no válida; una unión etiquetada
debe validar siempre la etiqueta antes de leer el valor.
Enfoque 1: Bloque de Documentación Único
Para uniones simples, un único bloque de comentario puede ser suficiente si se explica claramente el propósito y las restricciones de uso.
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23/** * Permite interpretar un valor de 32 bits de múltiples formas. * * Esta unión facilita la conversión entre representaciones enteras * y de punto flotante de 32 bits sin necesidad de casting explícito. * * ADVERTENCIA: La etiqueta y el miembro leído deben mantenerse consistentes. * La interpretación de otro miembro puede depender de la implementación y no * debe usarse como conversión portable entre representaciones. * * Miembros: * - como_int: Interpreta los 32 bits como entero con signo * - como_uint: Interpreta los 32 bits como entero sin signo * - como_float: Interpreta los 32 bits como número de punto flotante * - como_bytes: Acceso a los 4 bytes individuales */ typedef union { int32_t como_int; uint32_t como_uint; float como_float; uint8_t como_bytes[4]; } valor_32bits_t;
Ventajas:
Proporciona una visión completa del propósito de la unión.
Facilita explicar las restricciones de uso compartido de memoria.
Mantiene la definición visualmente limpia.
Desventajas:
Puede ser difícil de mantener si la unión crece.
La separación entre documentación y miembros puede causar desincronización.
Enfoque 2: Documentación Distribuida
Para uniones más complejas o uniones etiquetadas, el enfoque distribuido es preferible, especialmente cuando cada miembro tiene propósitos o restricciones específicas.
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30/** * Representa los datos específicos de diferentes tipos de mensajes de red. * * Esta unión debe usarse ÚNICAMENTE dentro de una estructura que incluya * un campo tipo (enum tipo_mensaje_t) para identificar qué miembro es válido. * * IMPORTANTE: El tamaño de esta unión es el del miembro más grande * (mensaje_archivo). Considerá las implicaciones de memoria al usarla * en arreglos o estructuras embebidas. */ typedef union { struct { // Válido cuando tipo == MSG_TEXTO char contenido[256]; // Mensaje de texto (máx. 255 chars + '\0') size_t longitud; // Longitud real del mensaje } mensaje_texto; struct { // Válido cuando tipo == MSG_NUMERO int64_t valor; // Valor numérico a transmitir bool es_firmado; // true si el valor es con signo } mensaje_numero; struct { // Válido cuando tipo == MSG_ARCHIVO char nombre[128]; // Nombre del archivo size_t tamano; // Tamaño en bytes uint32_t checksum; // Checksum CRC32 para verificación void *datos; // Puntero a los datos del archivo } mensaje_archivo; } datos_mensaje_t;
Ventajas:
Cada miembro tiene su documentación adyacente.
Facilita documentar estructuras anidadas dentro de la unión.
Ideal para uniones etiquetadas con miembros complejos.
Desventajas:
La definición puede volverse visualmente extensa.
Requiere disciplina para documentar todos los miembros consistentemente.
Documentación de Uniones para Manipulación de Bits
Para uniones usadas en programación de bajo nivel, la documentación debe ser especialmente detallada:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25/** * Permite manipular y acceder a un valor de 64 bits en diferentes granularidades. * * Esta unión es útil para operaciones de bajo nivel que requieren acceso * tanto al valor completo como a sus partes individuales (mitades, bytes, bits). * * NOTA DE PORTABILIDAD: El orden de los bytes (endianness) afecta cómo se * interpretan los campos byte[]. En sistemas little-endian, byte[0] es el * byte menos significativo. En big-endian, es el más significativo. * * Uso típico: Conversión de protocolos de red, serialización, depuración. */ typedef union { uint64_t completo; // Acceso al valor completo de 64 bits struct { // Acceso a mitades de 32 bits uint32_t bajo; // 32 bits inferiores uint32_t alto; // 32 bits superiores } mitades; uint16_t palabras[4]; // Acceso como 4 palabras de 16 bits uint8_t bytes[8]; // Acceso individual a los 8 bytes } registro_64bits_t;
Ejemplo Completo: Unión Etiquetada con Documentación Exhaustiva
Para uniones etiquetadas (el patrón más común y seguro), la documentación debe cubrir tanto la unión como la estructura contenedora:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58/** * Tipo de dato polimórfico que puede contener diferentes tipos de valores. * * Este tipo implementa el patrón de unión etiquetada (tagged union), * permitiendo almacenar y operar con diferentes tipos de datos de forma * segura. El campo 'tipo' SIEMPRE indica qué miembro de la unión 'datos' * contiene información válida. * * Uso correcto: * valor_t v = {.tipo = TIPO_ENTERO, .datos.entero = 42}; * if (v.tipo == TIPO_ENTERO) { * printf("%d\n", v.datos.entero); // ¡Seguro! * } * * Uso INCORRECTO: * valor_t v = {.tipo = TIPO_ENTERO, .datos.entero = 42}; * printf("%f\n", v.datos.flotante); // ¡Comportamiento indefinido! * * INVARIANTE: El campo 'tipo' debe ser siempre consistente con el * miembro de 'datos' que contiene información válida. */ typedef struct { /** * Identifica qué tipo de dato está almacenado actualmente. * Este campo DEBE actualizarse cada vez que se modifica 'datos'. */ enum { TIPO_VACIO, // Ningún valor almacenado (estado inicial) TIPO_ENTERO, // datos.entero es válido TIPO_FLOTANTE, // datos.flotante es válido TIPO_CADENA, // datos.cadena es válido (debe liberarse si se asignó dinámicamente) TIPO_PUNTERO // datos.puntero es válido } tipo; /** * Almacenamiento para el valor actual. * Solo el miembro correspondiente a 'tipo' contiene datos válidos. */ union { int64_t entero; // Entero de 64 bits con signo double flotante; // Número de punto flotante de precisión doble char *cadena; // Puntero a cadena (responsabilidad del usuario liberar) void *puntero; // Puntero genérico para tipos personalizados } datos; } valor_t; /** * Crea un valor de tipo entero. * * @param entero Valor entero a almacenar * @return Nuevo valor_t inicializado con el entero proporcionado */ valor_t crear_valor_entero(int64_t entero) { return (valor_t){.tipo = TIPO_ENTERO, .datos.entero = entero}; }
Recomendaciones Generales para Uniones
Advertencias de seguridad: Siempre documentá que solo un miembro es válido a la vez y que leer el miembro incorrecto causa comportamiento indefinido.
Uniones etiquetadas: Si la unión se usa con una etiqueta (enum), documentá claramente la relación entre el valor de la etiqueta y el miembro válido.
Tamaño en memoria: Mencioná el tamaño de la unión (determinado por su miembro más grande) si esto tiene implicaciones para el uso.
Consideraciones de portabilidad: Si la unión depende de representaciones específicas (endianness, tamaño de tipos), documentá estas dependencias.
Gestión de memoria: Si algún miembro contiene punteros que deben liberarse, documentá claramente la responsabilidad de gestión de memoria.
Casos de uso: Explicá para qué situaciones está diseñada la unión y cuándo debería (o no) usarse.
Para más detalles sobre el estilo de comentarios, consultá la regla 0x0201h: Escribí comentarios que expliquen el ‘porqué’, no el ‘qué’ sobre cómo escribir comentarios que expliquen el “porqué” y no el “qué”.
Ejercicio
Alineación de Miembros y Relleno en Estructuras (Padding)
En el desarrollo de software en C estándar, la disposición de los datos en la memoria física no siempre es contigua ni directa. Los procesadores modernos acceden a la memoria física mediante palabras de máquina (típicamente de 32 o 64 bits, es decir, 4 u 8 bytes). Para optimizar el rendimiento de las operaciones de lectura y escritura en el bus de datos, el hardware impone restricciones de alineación.
En una implementación concreta, cada tipo tiene una restricción de alineación.
No es correcto deducirla siempre del tamaño T. Si un dato no se encuentra
alineado, el costo depende de la arquitectura: puede degradar el rendimiento o,
en ciertas arquitecturas, provocar una excepción de hardware.
Para cumplir con estas restricciones sin intervención del programador, el compilador introduce automáticamente bytes de relleno denominados padding entre los miembros de una estructura.
Impacto en el Consumo de Memoria Física
Considerá la estructura ejemplo_padding_t presentada y analizada en el
Laboratorio 1:
1 2 3 4 5 6typedef struct { char a; // 1 byte int b; // 4 bytes char c; // 1 byte } ejemplo_padding_t;
A primera vista, se podría calcular que el tamaño físico de esta estructura es
la suma de sus partes: . Sin embargo, al evaluar sizeof(ejemplo_padding_t), el
resultado en una arquitectura de 32 o 64 bits es 12 bytes, como se demostró
empíricamente en el Laboratorio 1.
El compilador reorganiza el espacio aplicando las siguientes reglas:
Alineación de miembros: Cada miembro se ubica según la restricción de alineación de la implementación. En el ABI supuesto,
tipose ubica en el desplazamiento (offset) 0 eidrequiere un offset múltiplo de 4; por ende, se añaden 3 bytes de relleno (padding) en los desplazamientos 1, 2 y 3, ubicando aiden el offset 4 (ocupando los bytes 4, 5, 6 y 7).estadose coloca en el offset 8.Alineación de la estructura completa: El tamaño total de la estructura debe ser un múltiplo de la alineación de su miembro más restrictivo (el que requiera la mayor alineación). En este caso, el miembro más restrictivo es
id(4 bytes). La estructura finaliza en el byte 8 (después de ocupar 9 bytes en total). Para redondear al siguiente múltiplo de 4, el compilador inserta 3 bytes de relleno al final de la estructura, totalizando 12 bytes.
Table 1:Disposición de memoria física para sensor_desoptimizado_t (12 bytes)
| Offset | Byte 0 | Byte 1 | Byte 2 | Byte 3 |
|---|---|---|---|---|
| 0 | tipo (1B) | Padding | Padding | Padding |
| 4 | id (B0) | id (B1) | id (B2) | id (B3) |
| 8 | estado (1B) | Padding | Padding | Padding |
Estrategia de Optimización: Reordenamiento por Tamaño
Para mitigar el desperdicio de memoria física (que en el ejemplo anterior asciende al ), se debe declarar los miembros de la estructura en orden descendente de tamaño (o de restricción de alineación). Esto permite que los tipos de menor tamaño aprovechen los huecos naturales de alineación de los tipos más grandes.
Reescribiendo la estructura anterior:
1 2 3 4 5 6 7typedef struct { int id; // 4 bytes (offset 0-3) char tipo; // 1 byte (offset 4) char estado; // 1 byte (offset 5) // 2 bytes de padding al final para completar múltiplo de 4 } sensor_optimizado_t;
El tamaño físico de sensor_optimizado_t es de 8 bytes. Se logró reducir el
consumo de memoria en un simplemente alterando el orden de declaración.
Table 2:Disposición de memoria física para sensor_optimizado_t (8 bytes)
| Offset | Byte 0 | Byte 1 | Byte 2 | Byte 3 |
|---|---|---|---|---|
| 0 | id (B0) | id (B1) | id (B2) | id (B3) |
| 4 | tipo (1B) | estado (1B) | Padding | Padding |
Inspección de Desplazamientos con offsetof
La biblioteca estándar <stddef.h> proporciona la macro offsetof, que permite
obtener el desplazamiento en bytes de un miembro respecto al inicio de la
estructura.
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17#include <stddef.h> #include <stdio.h> typedef struct { char tipo; int id; char estado; } sensor_desoptimizado_t; int main(void) { printf("Tamaño total: %zu bytes\n", sizeof(sensor_desoptimizado_t)); printf("Offset de tipo: %zu\n", offsetof(sensor_desoptimizado_t, tipo)); printf("Offset de id: %zu\n", offsetof(sensor_desoptimizado_t, id)); printf("Offset de estado: %zu\n", offsetof(sensor_desoptimizado_t, estado)); return 0; }
Textos Fundamentales
Kernighan & Ritchie (2014). Sección 2.3: Constants y Apéndice A8.4: Enumeration Constants.
King (2008). Capítulo 16: Structures, Unions, and Enumerations.
Gustedt (2019). Level 1, Takeaway 1.6.2: Enumerations.
Estructuras y Uniones
Harbison & Steele (2002). Capítulo 5: Types. Referencia exhaustiva de enums, structs y unions.
Linden (1994). Capítulo 5: Thinking of Linking y Capítulo 6: Poetry in Motion.
Patrones de Diseño con Enums
Hanson (1996). Técnicas para crear interfaces limpias usando enumeraciones.
Lakos (1996). Capítulo 2: Ground Rules. Enumeraciones para legibilidad.
Bit-fields y Optimización
Warren (2012). Capítulo 2: Basics. Manipulación de bits y flags.
Fog, A. Optimizing Software in C++. Technical University of Denmark.
Disponible en: https://
www .agner .org /optimize/ Sección sobre layout de memoria y bit-fields.
Estándares y Especificaciones
ISO/IEC 9899:2018 - C18 Standard
Section 6.7.2.2: Enumeration specifiers. Definición formal.
Draft gratuito: http://
www .open -std .org /jtc1 /sc22 /wg14 /www /docs /n2310 .pdf
MISRA C:2012. Guidelines for the Use of the C Language in Critical Systems.
Reglas específicas para enumeraciones en sistemas críticos.
Rule 10.3: Value of enumeration constant shall be used only in appropriate context.
Recursos en Línea
C Enumerations - https://
en .cppreference .com /w /c /language /enum Referencia técnica completa con ejemplos.
Enum Best Practices - https://
stackoverflow .com /questions /tagged /enums+c Discusiones de la comunidad sobre patrones y anti-patrones.
Herramientas
Doxygen - https://
www .doxygen .nl /manual /commands .html #cmddef Documentación de enumeraciones con
@enum.
Cppcheck - http://
cppcheck .net/ Análisis estático que detecta uso incorrecto de enums.
Ejercicios de Autoevaluación
Sintaxis y offsetof
Solution to Exercise 3
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15#include <stdio.h> typedef struct { char nombre[50]; int edad; } persona_t; // La función recibe el puntero a la estructura void cumplir_anos(persona_t *persona) { if (persona != NULL) { // Acceso indirecto mediante el operador -> persona->edad++; } }
Solution to Exercise 4
En una arquitectura con alineación natural de 4 bytes:
c: Se ubica al inicio de la estructura (desplazamiento 0).i: Siendo unintde 4 bytes, requiere un desplazamiento múltiplo de 4. Comococupa 1 byte, el compilador inserta 3 bytes de padding. Por lo tanto,ise ubica en el desplazamiento 4.d: Se coloca inmediatamente después dei, que ocupa los bytes 4 al 7. Por ende,dse ubica en el desplazamiento 8. (Nota: El tamaño total de la estructura será 12 bytes, ya que se insertan 3 bytes de padding al final para completar un múltiplo de 4 bytes).
Código para imprimir los desplazamientos:
1 2 3 4 5 6 7 8 9#include <stddef.h> #include <stdio.h> int main() { printf("Offset de c: %zu\n", offsetof(struct Contenedor, c)); // Imprime 0 printf("Offset de i: %zu\n", offsetof(struct Contenedor, i)); // Imprime 4 printf("Offset de d: %zu\n", offsetof(struct Contenedor, d)); // Imprime 8 return 0; }
Solution to Exercise 5
1 2 3 4 5 6 7 8 9 10 11 12typedef struct { double x; double y; const char *etiqueta; } punto_t; int main() { // Inicialización explícita utilizando inicializadores designados punto_t origen = {.x = 0.0, .y = 0.0, .etiqueta = "Origen de Coordenadas"}; return 0; }
AoS, SoA y Diseño
Solution to Exercise 6
AoS (Arreglo de Estructuras): Organiza la memoria disponiendo cada partícula contigua con todos sus atributos (
x,y,z,masa, etc.). Al recorrer el arreglo para leer únicamentemasa, la CPU carga líneas de caché completas que contienen datos adyacentes irrelevantes para este cómputo (como las posiciones y velocidades), resultando en desperdicio de ancho de banda y fallos de caché.SoA (Estructura de Arreglos): Dispone todas las masas de forma contigua en un arreglo unidimensional único en memoria física. Esto permite a la CPU realizar lecturas lineales continuas y optimizar el uso de registros SIMD precargando múltiples masas contiguas sin ningún dato residual, maximizando la localidad espacial.
Solution to Exercise 7
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29#include <stdio.h> typedef struct { double x; double y; } punto_2d_t; typedef struct { punto_2d_t centro; double radio; } circulo_t; // Constructor con validación de invariante circulo_t crear_circulo(double cx, double cy, double r) { circulo_t circ; circ.centro.x = cx; circ.centro.y = cy; if (r <= 0.0) { fprintf(stderr, "Error: El radio debe ser mayor a cero. Asignando 1.0 " "por seguridad.\n"); circ.radio = 1.0; } else { circ.radio = r; } return circ; }
Solution to Exercise 2
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47#include <stdio.h> typedef enum { EVENTO_TECLA_PRESIONADA, EVENTO_CLICK_MOUSE, EVENTO_SALIR } tipo_evento_t; typedef struct { int x; int y; } pos_mouse_t; typedef struct { tipo_evento_t tipo; union { char tecla; pos_mouse_t pos; } datos; } evento_t; void procesar_evento(const evento_t *evento) { switch (evento->tipo) { case EVENTO_TECLA_PRESIONADA: printf("Tecla presionada: '%c'\n", evento->datos.tecla); break; case EVENTO_CLICK_MOUSE: printf("Click de mouse en (%d, %d)\n", evento->datos.pos.x, evento->datos.pos.y); break; case EVENTO_SALIR: printf("Evento de salida recibido.\n"); break; } } int main() { evento_t ev1 = {.tipo = EVENTO_TECLA_PRESIONADA, .datos.tecla = 'q'}; evento_t ev2 = {.tipo = EVENTO_CLICK_MOUSE, .datos.pos = {120, 80}}; evento_t ev3 = {.tipo = EVENTO_SALIR}; procesar_evento(&ev1); procesar_evento(&ev2); procesar_evento(&ev3); return 0; }
Uniones y Tagged Unions
Solution to Exercise 8
El tamaño de una union está determinado por el tamaño de su miembro más
grande, con alineación ajustada a su miembro con restricciones más fuertes:
union A: El miembro más grande esint i(4 bytes). Por lo tanto, el tamaño total es de 4 bytes (donde los 1 byte delchar ccomparten la misma ubicación física).union B: El miembro más grande eschar buffer[20](20 bytes). Sin embargo, el miembro con restricción de alineación más fuerte esdouble d(8 bytes), lo que obliga a que el tamaño de la unión sea un múltiplo de 8 bytes. Para alinear correctamente la unión, el compilador redondea el tamaño a 24 bytes. Por ende, el tamaño total es de 24 bytes.
Solution to Exercise 9
1 2 3 4 5 6 7 8 9 10#include <stdint.h> typedef union { uint16_t valor; // Acceso completo de 16 bits struct { uint8_t bajo; // Byte menos significativo (en little-endian) uint8_t alto; // Byte más significativo (en little-endian) } bytes; } registro_t;
Solution to Exercise 10
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39#include <stdio.h> typedef enum { FIGURA_CIRCULO, FIGURA_RECTANGULO } tipo_figura_t; typedef struct { tipo_figura_t tipo; union { struct { double radio; } circulo; struct { double ancho; double alto; } rectangulo; } datos; } figura_t; double calcular_area(const figura_t *figura) { if (figura == NULL) { return 0.0; } switch (figura->tipo) { case FIGURA_CIRCULO: return 3.14159265 * figura->datos.circulo.radio * figura->datos.circulo.radio; case FIGURA_RECTANGULO: return figura->datos.rectangulo.ancho * figura->datos.rectangulo.alto; default: return 0.0; } }
Alineación y Padding
Solution to Exercise 11
En una arquitectura x86_64 de 64 bits:
c1ocupa 1 byte (offset 0).d(8 bytes) requiere estar alineado a una dirección múltiplo de 8. Por ende, se insertan 7 bytes de padding (offsets 1 al 7), ubicando aden el offset 8.c2ocupa 1 byte (offset 16).Para alinear la estructura completa a múltiplos de 8 (el tamaño de
double), el compilador añade 7 bytes de padding al final (del offset 17 al 23). El tamaño destruct Suboptimoes de 24 bytes, desperdiciando 14 bytes en padding.
La versión optimizada ordenando los miembros de mayor a menor tamaño es:
1 2 3 4 5 6 7struct Optimizado { double d; // 8 bytes (offset 0) char c1; // 1 byte (offset 8) char c2; // 1 byte (offset 9) // 6 bytes de padding al final para completar el múltiplo de 8 };
El tamaño de struct Optimizado se reduce a 16 bytes.
Solution to Exercise 12
El padding final se inserta para garantizar la correcta alineación de todos los
elementos cuando la estructura se utiliza dentro de un arreglo.
En un arreglo, los elementos se disponen de forma contigua en memoria virtual.
Si no se agregaran bytes de relleno al final de la estructura para completar un
múltiplo del tamaño del miembro más restrictivo, el segundo elemento del arreglo
(ubicado en la dirección dirección_base + sizeof(estructura)) tendría sus
miembros desalineados. Por ejemplo, en una estructura que contiene un int y un
char en ese orden, el padding final de 3 bytes tras el char asegura que el
siguiente int en el arreglo inicie en una dirección múltiplo de 4.
Solution to Exercise 13
Los procesadores modernos leen de la memoria RAM principal a través de palabras físicas (bloques de 4 u 8 bytes). La alineación natural establece que un dato de tamaño debe residir en una dirección que sea divisible por . Si un dato de 4 bytes se almacena en una dirección no alineada (por ejemplo, dividida entre dos palabras de memoria), el controlador de memoria se ve obligado a realizar dos lecturas de bus de datos, aplicar operaciones de desplazamiento de bits (shifting) y máscaras lógicas para unir los fragmentos del dato. Esto duplica el tiempo de acceso al bus de datos y degrada la velocidad de ejecución. En algunas arquitecturas embebidas y RISC estrictas, el acceso no alineado no está soportado y produce una interrupción por fallo de alineación de hardware.
Glosario
- enumeración
- Un tipo de dato en C que define un conjunto de constantes enteras nombradas. Permite asociar nombres simbólicos significativos a valores numéricos, mejorando la legibilidad del código y reduciendo errores relacionados con el uso de “números mágicos”.
- constante enumerada
- Cada uno de los identificadores definidos dentro de una enumeración. Por defecto, reciben valores enteros consecutivos comenzando desde 0, pero pueden tener valores explícitos asignados por el programador.
- máquina de estados finita
- Un modelo computacional que consiste en un número finito de estados, transiciones entre esos estados, y acciones. Las enumeraciones son ideales para representar los estados posibles en este tipo de sistemas.
- flag de bits
- Una técnica donde se usan valores que son potencias de 2 para representar opciones que pueden combinarse usando operadores bitwise. Cada bit en la representación binaria representa una opción específica que puede estar activada o desactivada.
- valor centinela
- Un valor especial que marca el final o límite de un conjunto
de valores válidos. En enumeraciones, se usa frecuentemente un elemento
adicional (como
ENUM_MAX) para facilitar la validación de rangos y iteración.
Síntesis y Resumen
Las estructuras (struct) agrupan tipos de datos heterogéneos bajo un mismo
nombre, ordenándose secuencialmente en memoria con posibles rellenos de
alineación (padding). Las uniones (union) comparten el mismo espacio físico
de memoria para todos sus miembros, permitiendo representar datos alternativos
eficientemente (por ejemplo, en uniones etiquetadas). Los campos de bits
optimizan el espacio agrupando datos al nivel de bits individuales.
Referencias y Lecturas Complementarias
Kernighan, B. W. y Ritchie, D. M. Kernighan & Ritchie, 2014. The C Programming Language (2.ª edición). Prentice Hall.
Consultá el Capítulo 6: Structures, que expone la base histórica de las estructuras en C, la anidación de tipos, el pasaje de estructuras a funciones y el direccionamiento mediante punteros de tipo struct.
King, K. N. King, 2008. C Programming: A Modern Approach (2.ª edición). W. W. Norton & Company.
Revisá el Capítulo 16: Structures, Unions, and Enumerations para un análisis pedagógico brillante sobre la inicialización de estructuras (incluyendo inicializadores designados de C99), el uso seguro de uniones y la modelización de uniones etiquetadas (tagged unions).
Gustedt, J. Gustedt, 2019. Modern C. Manning Publications.
Estudiá las secciones correspondientes al almacenamiento y alineación de datos estructurados, donde se detalla el comportamiento del alineamiento natural de las variables y el cálculo preciso de los bytes de relleno (padding).
Sommers, J. Sommers, 2025. jsommers/cbook.
Consultá los capítulos referidos a estructuras y campos de bits para ver ejemplos prácticos de cómo empaquetar información y optimizar la utilización de la memoria RAM.
- Kernighan, B. W., & Ritchie, D. M. (2014). C Programming Language, 2nd Edition.
- King, K. N. (2008). C Programming: A Modern Approach (2nd ed.). W. W. Norton & Company.
- Gustedt, J. (2019). Modern C. Manning Publications. https://modernc.gforge.inria.fr/
- Harbison, S. P., & Steele, G. L. (2002). C: A Reference Manual (5th ed.). Prentice Hall.
- van der Linden, P. (1994). Expert C Programming: Deep C Secrets. Prentice Hall.
- Hanson, D. R. (1996). C Interfaces and Implementations: Techniques for Creating Reusable Software. Addison-Wesley.
- Lakos, J. (1996). Large-Scale C++ Software Design. Addison-Wesley.
- Warren, H. S. (2012). Hacker’s Delight (2nd ed.). Addison-Wesley.
- Sommers, J. (2025). jsommers/cbook. https://github.com/jsommers/cbook (Original work published 2017)