Prerrequisitos: lazos, funciones, arreglos y noción de TAD. Para medir ejemplos en Linux/WSL2 se usa
clock_gettimede<time.h>.Objetivo: separar una medición concreta de la tasa de crecimiento y comparar alternativas mediante notación asintótica.
Comprobación de salida: duplicá el tamaño de entrada, registrá dos mediciones y explicá por qué no constituyen por sí solas una prueba de Big-O.
Medición mínima reproducible
La complejidad predice tendencias; una medición controla qué ocurre en una
máquina concreta. Este ejemplo mide una suma lineal y debe compilarse con
gcc -Wall -Wextra -std=c11 -pedantic medicion.c -o medicion:
#define _POSIX_C_SOURCE 200809L
#include <stdio.h>
#include <time.h>

int main(void)
{
    const long limite = 1000000L;
    volatile long suma = 0;
    struct timespec inicio, fin;
    clock_gettime(CLOCK_MONOTONIC, &inicio);
    for (long i = 0; i < limite; i++) suma += i;
    clock_gettime(CLOCK_MONOTONIC, &fin);
    long ns = (fin.tv_sec - inicio.tv_sec) * 1000000000L +
              (fin.tv_nsec - inicio.tv_nsec);
    printf("suma=%ld, tiempo=%ld ns\\n", suma, ns);
    return 0;
}
Duplicá limite varias veces y compará la tendencia; una única medición no
demuestra Big-O, pero conecta el modelo con evidencia observable.
Desarrollo
Introducción: El Estudio de la Eficiencia
El análisis de algoritmos es una disciplina fundamental en la ciencia de la computación que se enfoca en cuantificar los recursos que un algoritmo consume. Su propósito es predecir, de manera formal y rigurosa, cómo se comportará un algoritmo en términos de tiempo de ejecución y uso de memoria a medida que el tamaño de la entrada de datos crece.
El objetivo principal no es obtener tiempos exactos en segundos —una métrica volátil que depende del hardware, el compilador y el sistema operativo— sino establecer una base teórica para:
Comparar algoritmos: Determinar objetivamente cuál de dos algoritmos es más eficiente para resolver un mismo problema.
Predecir la escalabilidad: Entender si un algoritmo seguirá siendo viable cuando el volumen de datos aumente de miles a millones o miles de millones de registros.
Optimizar el código: Identificar los cuellos de botella y las partes críticas de un programa que más impactan en su rendimiento.
Para lograr esto, la herramienta central es el análisis asintótico.
Análisis Asintótico: Enfocándose en lo que Importa
El análisis asintótico es una metodología matemática que describe el comportamiento de una función en su límite, es decir, cuando el tamaño de la entrada () se vuelve arbitrariamente grande (tiende al infinito). Este enfoque nos permite abstraernos de los detalles de la implementación y del hardware, y concentrarnos en la tasa de crecimiento intrínseca del algoritmo.
Al analizar una función de costo como , observamos que para valores grandes de , el término domina a los demás. El análisis asintótico nos permite simplificar esta expresión a su orden de crecimiento, que es , ignorando constantes multiplicativas (3) y términos de menor orden ().
Las Notaciones Asintóticas: O, Ω, y Θ
Para formalizar este análisis, utilizamos un conjunto de notaciones que describen los límites del crecimiento de la función de costo de un algoritmo.
1. Notación Big O (O) - Cota Superior (Peor Caso)
La notación Big O es la más utilizada en la práctica, ya que describe una cota superior asintótica. Nos ofrece una garantía sobre el rendimiento del algoritmo: nunca será peor que esta cota.
Definición Intuitiva: Una función pertenece a si su tasa de crecimiento es igual o más lenta que la de para entradas suficientemente grandes.
Definición Formal: si existen constantes positivas y tales que para todo .
Uso Práctico: Representa el peor caso de ejecución de un algoritmo.
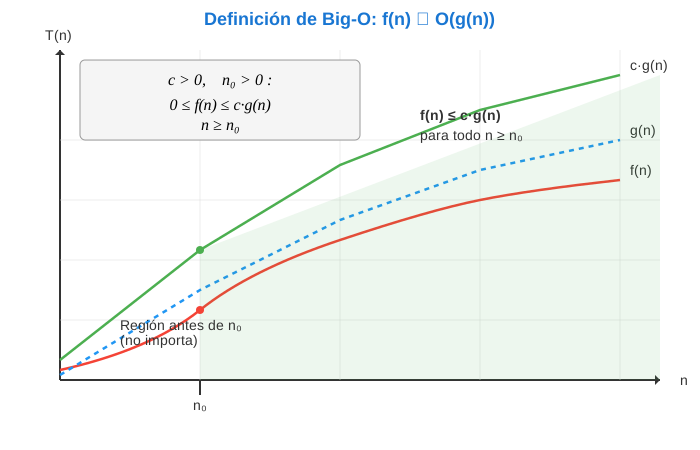
Figure 1:Representación gráfica de la cota superior asintótica . A partir de , la función es siempre mayor o igual a .
2. Notación Omega (Ω) - Cota Inferior (Mejor Caso)
La notación Omega describe una cota inferior asintótica. Nos garantiza que el rendimiento del algoritmo nunca será mejor que esta cota.
Definición Intuitiva: Una función pertenece a si su tasa de crecimiento es igual o más rápida que la de .
Definición Formal: si existen constantes positivas y tales que para todo .
Uso Práctico: Representa el mejor caso de ejecución.
3. Notación Theta (Θ) - Cota Ajustada (Caso Exacto)
La notación Theta proporciona la descripción más precisa del comportamiento de un algoritmo, acotándolo tanto por arriba como por abajo.
Definición Intuitiva: Una función pertenece a si su tasa de crecimiento es exactamente la misma que la de .
Relación: si y solo si y .
Uso Práctico: Describe el comportamiento del algoritmo de forma ajustada, a menudo representando el caso promedio o un escenario donde el mejor y el peor caso coinciden.
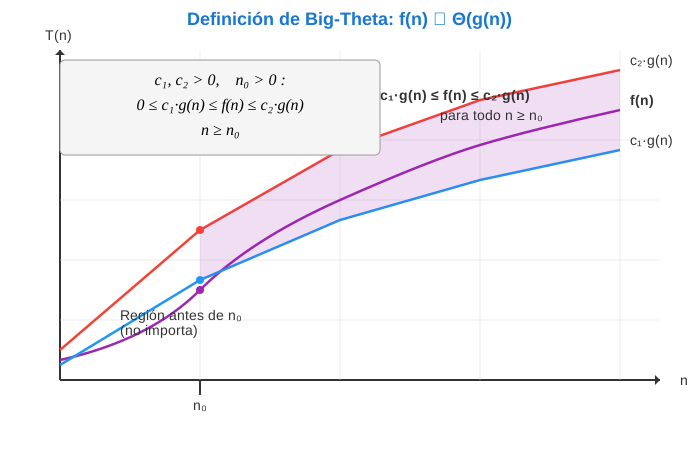
Figure 2:Representación gráfica de la cota ajustada asintótica . La función queda atrapada entre las cotas y para todo .
Notaciones Menos Comunes
Little-o (Límite Asintótico Estricto)
si para toda constante , existe tal que:
Equivalentemente:
Ejemplo: pero
Little-omega (Límite Inferior Estricto)
si para toda constante , existe tal que:
Propiedades Algebraicas
Las notaciones asintóticas tienen propiedades útiles:
Transitividad: Si y , entonces
Reflexividad:
Simetría: Si , entonces
Suma:
Producto:
Ejercicios de Notaciones Asintóticas
Jerarquía de Complejidades
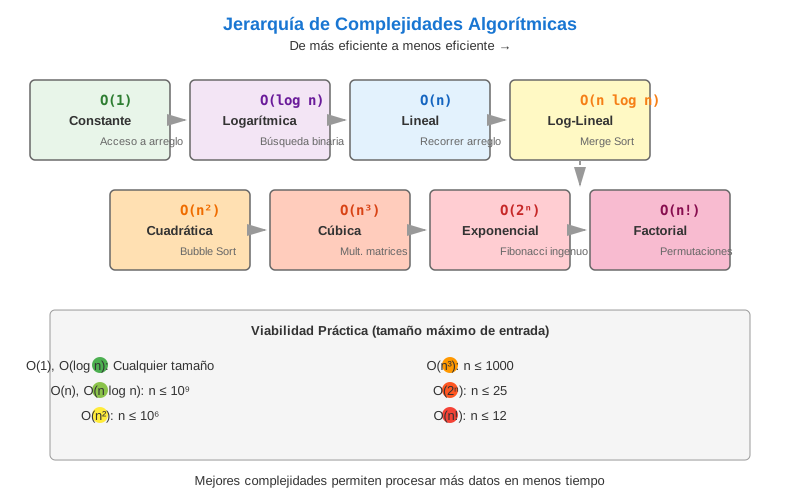
Figure 3:Jerarquía de las clases de complejidad más comunes, ordenadas de más eficiente a menos eficiente.
Clasificación Detallada
Constante: 
Características:
El tiempo no depende del tamaño de entrada
Más eficiente posible
Ejemplo: acceso a un elemento de arreglo, operaciones aritméticas
Código ejemplo:
1 2 3 4int obtener_primero(int arr[], int n) { return arr[0]; // O(1): una operación, independiente de n }
Logarítmica: 
Características:
Crece muy lentamente
Típica de algoritmos que dividen el problema a la mitad en cada paso
Base del logaritmo irrelevante asintóticamente: la base del logaritmo no afecta a la clase de complejidad porque cambiar de base equivale a multiplicar por una constante. Si aplicamos la fórmula de cambio de base:
Dado que es una constante para bases fijas y , por definición asintótica se cumple que (por ejemplo, ).
Ejemplos: búsqueda binaria, operaciones en árboles balanceados
Código ejemplo:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23// Búsqueda binaria: O(log n) // Precondición: el arreglo 'arr' debe estar ordenado de menor a mayor. int busqueda_binaria(int arr[], int n, int clave) { int izq = 0, der = n - 1; while (izq <= der) { // Se reduce a la mitad en cada lazo int medio = izq + (der - izq) / 2; if (arr[medio] == clave) { return medio; } if (arr[medio] < clave) { izq = medio + 1; } else { der = medio - 1; } } return -1; }
Análisis:
En cada iteración del lazo, el espacio de búsqueda se reduce a la mitad. Si inicialmente hay elementos, después de lazos quedan . El algoritmo termina cuando , es decir, .
Lineal: 
Características:
Tiempo proporcional al tamaño de entrada
Óptimo para problemas que requieren examinar todos los datos
Duplicar la entrada duplica el tiempo
Ejemplos: búsqueda secuencial, recorrer un arreglo, suma de elementos
Código ejemplo:
1 2 3 4 5 6 7 8 9 10// Suma de elementos: O(n) int sumar_elementos(int arr[], int n) { int suma = 0; for (int i = 0; i < n; i++) { // n iteraciones suma += arr[i]; // O(1) por iteración } return suma; }
Log-Lineal: 
Características:
Complejidad de algoritmos óptimos de ordenamiento por comparación
Crece más que lineal pero menos que cuadrático
Muy eficiente en la práctica
Ejemplos: Merge Sort, Heap Sort, Quick Sort (promedio)
Código ejemplo (Merge Sort):
1 2 3 4 5 6 7 8 9 10 11// Merge Sort: O(n log n) void merge_sort(int arr[], int izq, int der) { if (izq < der) { int medio = izq + (der - izq) / 2; merge_sort(arr, izq, medio); // T(n/2) merge_sort(arr, medio + 1, der); // T(n/2) merge(arr, izq, medio, der); // O(n) } }
Análisis: La recurrencia es , que resuelve a por el Teorema Maestro.
Cuadrática: 
Características:
Típica de algoritmos con dos lazos anidados
Duplicar la entrada cuadruplica el tiempo
Práctica para pequeño, inviable para grande
Ejemplos: Bubble Sort, Selection Sort, Insertion Sort
Código ejemplo:
1 2 3 4 5 6 7 8 9 10 11 12 13 14// Bubble Sort: O(n²) void bubble_sort(int arr[], int n) { for (int i = 0; i < n - 1; i++) { // n iteraciones for (int j = 0; j < n - i - 1; j++) { // n-i iteraciones if (arr[j] > arr[j + 1]) { intercambiar(&arr[j], &arr[j + 1]); // O(1) } } } }
Análisis: Total de comparaciones =
Cúbica: 
Características:
Tres lazos anidados o algoritmos con subcubos
Viable solo para pequeño
Ejemplos: multiplicación ingenua de matrices, algunos algoritmos de grafos
Código ejemplo:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15// Multiplicación de matrices: O(n³) void multiplicar_matrices(int A[][N], int B[][N], int C[][N], int n) { for (int i = 0; i < n; i++) { // n iteraciones for (int j = 0; j < n; j++) { // n iteraciones C[i][j] = 0; for (int k = 0; k < n; k++) { // n iteraciones C[i][j] += A[i][k] * B[k][j]; } } } }
Exponencial: 
Características:
Crece extremadamente rápido
Inviable para en la mayoría de casos
Común en algoritmos de fuerza bruta
Ejemplos: subconjuntos de un conjunto, Torre de Hanoi, algunos problemas NP-completos
Código ejemplo:
1 2 3 4 5 6 7 8 9// Fibonacci recursivo ingenuo: O(2^n) int fibonacci(int n) { if (n <= 1) { return n; } return fibonacci(n - 1) + fibonacci(n - 2); // Dos llamadas recursivas }
Análisis: La relación de recurrencia para el tiempo de ejecución es . Para resolver la parte homogénea de esta ecuación de diferencias, , proponemos una solución de la forma . Al sustituir, obtenemos la ecuación característica:
cuyas raíces son (la razón áurea) y . La solución general de la recurrencia es una combinación lineal de ambas potencias, dominada asintóticamente por la raíz de mayor magnitud, por lo que .
Factorial: 
Características:
La complejidad más ineficiente de las comunes
Solo viable para aproximadamente
Aparece en problemas de permutaciones
Ejemplos: generar todas las permutaciones, problema del viajante (fuerza bruta)
Código ejemplo:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15// Generar permutaciones: O(n!) void generar_permutaciones(int arr[], int inicio, int fin) { if (inicio == fin) { imprimir(arr, fin + 1); return; } for (int i = inicio; i <= fin; i++) { intercambiar(&arr[inicio], &arr[i]); generar_permutaciones(arr, inicio + 1, fin); // (n-1)! llamadas intercambiar(&arr[inicio], &arr[i]); } }
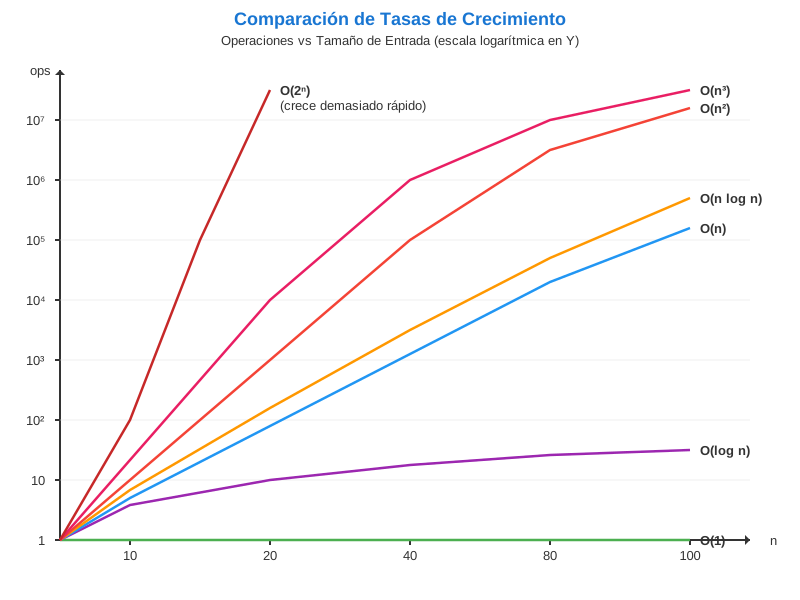
Figure 4:Comparación del crecimiento de diferentes funciones de complejidad para valores de hasta 100.
Tabla Comparativa de Crecimiento
| 10 | 3 | 10 | 33 | 100 | 1K | 1K | 3.6M |
| 20 | 4 | 20 | 86 | 400 | 8K | 1M | |
| 30 | 5 | 30 | 147 | 900 | 27K | 1B | |
| 100 | 7 | 100 | 664 | 10K | 1M | ||
| 1000 | 10 | 1K | 9.9K | 1M | 1B | — | — |
Ejercicios de Jerarquía de Complejidades
Técnicas de Análisis
Análisis de Lazos
Lazo Simple
1 2 3 4for (int i = 0; i < n; i++) { // Operación O(1) }
Análisis:
Lazos Anidados
1 2 3 4 5 6 7for (int i = 0; i < n; i++) { // n iteraciones for (int j = 0; j < n; j++) { // n iteraciones // Operación O(1) } }
Análisis:
Lazos con Dependencia
1 2 3 4 5 6 7for (int i = 0; i < n; i++) { for (int j = i; j < n; j++) { // Depende de i // Operación O(1) } }
Análisis:
Lazo Logarítmico
1 2 3 4for (int i = 1; i < n; i *= 2) { // Operación O(1) }
Análisis: Si comienza en 1 y se duplica cada iteración, el lazo ejecuta veces donde , es decir, . Por tanto, .
Análisis de Recursión
Método de Sustitución
El método de sustitución (o método de inducción matemática) se utiliza para resolver recurrencias mediante dos etapas:
Expandir (desarrollar) la relación de recurrencia para adivinar el patrón de la solución.
Probar la solución por inducción matemática para verificar su exactitud formal.
Ejemplo de desarrollo paso a paso: Consideremos la recurrencia , donde es el costo constante de la operación básica (), con el caso base (donde es otra constante).
Expansión por sustitución sucesiva: Comenzamos sustituyendo recursivamente la fórmula:
Paso 1:
Paso 2: Sustituimos usando la misma definición: .
Paso 3: Sustituimos :
Generalización del patrón: Podemos generalizar la expresión para el paso :
Aplicación del caso base: Deseamos alcanzar el caso base . Para ello, definimos , lo que implica . Sustituyendo en nuestra ecuación generalizada:
Dado que y son constantes, la función de costo se reduce a una ecuación lineal:
Método del Árbol de Recursión
Antes de enunciar el Teorema Maestro, es fundamental visualizar cómo se distribuye el trabajo en un algoritmo recursivo de tipo divide y vencerás. El árbol de recursión es una herramienta gráfica donde:
Cada nodo representa una llamada recursiva.
El costo etiquetado en cada nodo es el trabajo no recursivo realizado en esa llamada específica.
La suma del trabajo de todos los nodos en todos los niveles del árbol determina el costo total del algoritmo.
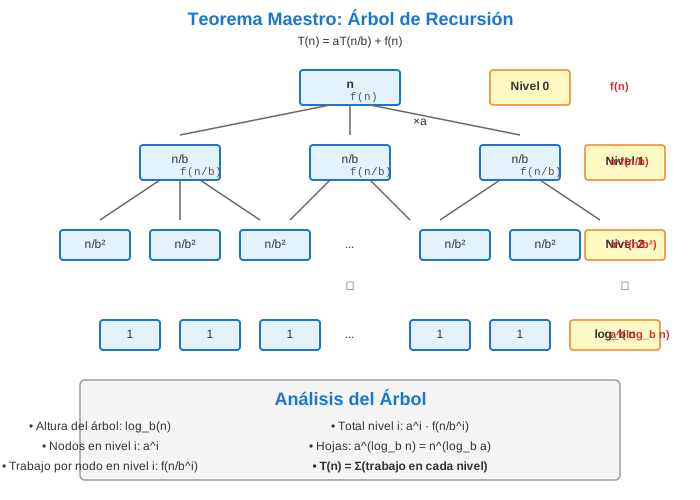
Figure 5:Árbol de recursión ilustrando el Teorema Maestro y cómo se distribuye el trabajo en cada nivel del árbol.
Ejemplo de análisis con árbol: Consideremos la recurrencia (con caso base ):
Nivel 0:                n              → costo: n
                       / \
Nivel 1:            n/2   n/2          → costo: n
                     / \   / \
Nivel 2:         n/4 n/4 n/4 n/4       → costo: n
                  ...
Cantidad de subproblemas por nivel: En el nivel , tenemos subproblemas.
Tamaño de cada subproblema: En el nivel , cada subproblema tiene tamaño .
Costo del trabajo no recursivo por nivel: En cada nivel , la suma del trabajo es .
Altura del árbol (número de niveles): Dado que el tamaño del problema se divide por 2 en cada paso, el proceso finaliza cuando , es decir, tras niveles.
Costo total: Sumando todos los niveles, el costo total es , lo que equivale a .
Teorema Maestro
El Teorema Maestro es una receta matemática que sistematiza este análisis para recurrencias de la forma general:
donde:
es la cantidad de subproblemas recursivos creados.
es el factor por el cual se divide el tamaño del problema original.
es una función asintóticamente positiva que representa el costo de la división y combinación del trabajo en el nivel actual.
Al comparar el trabajo en las hojas del árbol (que es ) con el trabajo no recursivo en la raíz (), el Teorema Maestro determina cuál de los dos domina la complejidad asintótica:
Caso 1 (Dominan las hojas): Si para algún , entonces:
Caso 2 (Trabajo balanceado): Si para algún , entonces:
Caso 3 (Domina la raíz): Si para algún , y se cumple la condición de regularidad ( para alguna constante y suficientemente grande), entonces:
La condición de regularidad garantiza que la tasa de trabajo no recursivo decrezca geométricamente a medida que se desciende en el árbol de recursión. Si no se satisface esta condición, no se puede aplicar el Caso 3 del Teorema Maestro.
Ejemplos de aplicación:
Merge Sort:
→ Caso 2 con
Solución:
Búsqueda Binaria:
→ Caso 2 con
Solución:
Multiplicación de Karatsuba:
→ Caso 1
Solución:
Análisis Amortizado
El análisis amortizado considera el costo promedio de una secuencia de operaciones, permitiendo que algunas operaciones sean costosas si la mayoría son baratas.
Método del Agregado
Ejemplo: Arreglo dinámico redimensionable en C.
Supongamos que implementamos un arreglo dinámico en C mediante una estructura
que almacena un puntero, el tamaño actual y la capacidad máxima de
almacenamiento. Cuando el arreglo alcanza su capacidad límite, duplicamos su
tamaño utilizando realloc:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24typedef struct { int *datos; size_t tamaño; size_t capacidad; } arreglo_dinamico_t; bool insertar_arreglo(arreglo_dinamico_t *arr, int valor) { if (arr->tamaño >= arr->capacidad) { size_t nueva_capacidad = arr->capacidad * 2; int *nuevo_espacio = realloc(arr->datos, nueva_capacidad * sizeof(int)); if (nuevo_espacio == NULL) { return false; } arr->datos = nuevo_espacio; arr->capacidad = nueva_capacidad; } arr->datos[arr->tamaño] = valor; arr->tamaño++; return true; }
Analicemos el costo de una secuencia de inserciones consecutivas en el lazo de carga, comenzando con una capacidad inicial de 1:
Si la inserción no requiere redimensionamiento, toma tiempo constante: 1 operación.
Si requiere redimensionamiento, requiere reasignar memoria y copiar los elementos existentes, tomando operaciones (donde es el tamaño en ese momento).
Para inserciones (donde es una potencia de 2), el costo total acumulado es la suma de los accesos normales y los costos de copia por redimensionamiento:
Costo amortizado: Al dividir el costo total por la cantidad de operaciones, obtenemos por cada inserción individual.
Método del Potencial
El método del potencial analiza la complejidad amortizada definiendo una función potencial sobre los estados de la estructura de datos. Esta función asocia un número real no negativo a la estructura tras la operación .
El costo amortizado de la -ésima operación se define como:
donde es el costo real de la operación y es el cambio en el potencial.
Análisis del Arreglo Dinámico Para un arreglo dinámico, definimos la función potencial después de la operación como:
donde es el tamaño actual (número de elementos) y es la capacidad actual.
Precondición de validez: Como la capacidad es a lo sumo el doble del tamaño y al menos igual, tenemos que . Inicialmente, con un arreglo vacío, y , por lo que .
Analicemos los dos escenarios posibles para la -ésima inserción:
Escenario 1: Inserción sin Redimensionamiento
El arreglo tiene espacio libre ().
El costo real es constante: (copiar el elemento en el arreglo).
El tamaño aumenta en uno (), y la capacidad permanece constante ().
El cambio en el potencial es:
El costo amortizado calculado es:
Escenario 2: Inserción con Redimensionamiento
El arreglo está lleno (). Para insertar, se debe duplicar la capacidad: .
El costo real de esta inserción implica alocar nueva memoria y copiar todos los elementos existentes más el nuevo: .
El tamaño aumenta en uno (), y la capacidad se duplica ().
Calculamos la variación del potencial :
El costo amortizado calculado es:
Conclusión En ambos escenarios (con o sin redimensionamiento), el costo amortizado de una inserción en el arreglo dinámico es exactamente 3, lo que demuestra formalmente que la operación de inserción tiene una complejidad de amortización constante:
Ejercicios de Técnicas de Análisis
Complejidad Espacial
La complejidad espacial mide la cantidad de memoria adicional que un algoritmo requiere.
Clasificación
: Espacio constante, independiente de la entrada
: Típico de algoritmos recursivos que dividen el problema
: Espacio lineal, como copiar un arreglo
: Matrices cuadradas
Recursión y Pila de Llamadas
Cada llamada recursiva ocupa espacio en la pila. La profundidad máxima de recursión determina la complejidad espacial.
Ejemplo: Fibonacci recursivo
1 2 3 4 5 6 7 8int fibonacci(int n) { if (n <= 1) { return n; } return fibonacci(n - 1) + fibonacci(n - 2); }
Complejidad temporal:
Complejidad espacial: (profundidad máxima de la pila)
Trade-off Tiempo-Espacio
A menudo es posible reducir tiempo usando más espacio (memoización) o viceversa.
Ejemplo: Fibonacci con memoización
1 2 3 4 5 6 7 8 9 10 11 12 13int fibonacci_memo(int n, int memo[]) { if (n <= 1) { return n; } if (memo[n] != -1) { return memo[n]; } memo[n] = fibonacci_memo(n - 1, memo) + fibonacci_memo(n - 2, memo); return memo[n]; }
Complejidad temporal: (cada valor se calcula una vez)
Complejidad espacial: (arreglo de memoización + pila)

Figure 6:Ilustración del trade-off entre tiempo y espacio en el problema de Fibonacci.
Ejercicios de Complejidad Espacial
Límites Inferiores y Óptimalidad
Límites Inferiores Basados en Información
Un límite inferior establece que ningún algoritmo puede resolver un problema más rápido que cierta complejidad.
Teorema: Ordenamiento por Comparación
Enunciado: Cualquier algoritmo que ordene elementos mediante comparaciones requiere al menos comparaciones en el peor caso.
Demostración (árbol de decisión):
Un algoritmo de ordenamiento por comparación puede modelarse como un árbol binario de decisión.
Cada hoja representa una permutación posible de los elementos de entrada.
Hay permutaciones posibles, por tanto, el árbol debe tener al menos hojas.
Un árbol binario de altura tiene como máximo hojas.
Para que el árbol pueda representar todas las salidas válidas, se requiere que , lo que implica .
Demostramos la cota inferior de expandiendo la sumatoria y acotándola inferiormente desde su término medio: $$ \log_2(n!) = \sum_{i=1}^n \log_2 i \geq \sum_{i=n/2}^n \log_2 i \geq \sum_{i=n/2}^n \log_2(n/2) = \frac{n}{2} \log_2(n/2) = \frac{n}{2} (\log_2 n
\in \Omega(n \log n) $$
Conclusión: Cualquier algoritmo basado en comparaciones requiere al menos comparaciones en el peor caso. Algoritmos como Merge Sort y Heap Sort son, por lo tanto, óptimos.
Algoritmos Óptimos
Un algoritmo es asintóticamente óptimo si su complejidad coincide con el límite inferior teórico del problema.
Ejemplos:
Búsqueda en arreglo no ordenado: (deben revisarse todos los elementos)
Multiplicación de matrices: (algoritmo de Coppersmith-Winograd), límite inferior
Más Allá: Una Introducción a la Teoría de la Complejidad (P vs. NP)
Mientras que el análisis de algoritmos se enfoca en determinar la eficiencia de una solución específica, la teoría de la complejidad aborda una pregunta más fundamental: ¿cuál es la dificultad inherente de un problema? No se pregunta “¿cuán rápido es mi algoritmo para ordenar?”, sino “¿cuán rápido puede ser cualquier algoritmo que ordene?”.
Esta disciplina clasifica los problemas computacionales en clases de complejidad basadas en los recursos (tiempo y memoria) que se requieren para resolverlos en el peor de los casos, independientemente del algoritmo específico utilizado.
Conceptos de Complejidad: Intratabilidad y las Clases P y NP
En el análisis de algoritmos, no solo nos interesa determinar la complejidad asintótica exacta, sino también clasificar los problemas según si son resolubles de forma eficiente en la práctica. Esta distinción introduce la noción de intratabilidad.
Problemas Tratables vs. Intratables
Problemas Tratables: Son aquellos para los cuales existe un algoritmo que los resuelve en tiempo polinomial en el peor de los casos (es decir, para alguna constante ). Cuando la entrada crece, el tiempo requerido aumenta de forma manejable por el hardware. Ejemplos: Ordenar una lista, buscar un elemento en un arreglo, encontrar el camino más corto en un grafo.
Problemas Intratables: Son problemas de gran complejidad computacional para los cuales no se conocen algoritmos polinomiales que garanticen una solución óptima en el peor de los casos. Sus mejores algoritmos conocidos requieren tiempo exponencial (ej. ) o factorial (ej. ), volviéndolos imposibles de computar para tamaños de entrada moderados.
Las Clases P y NP
Para formalizar esta clasificación, la teoría de la complejidad define conjuntos de problemas llamados clases de complejidad:
La Clase P: Contiene a todos los problemas de decisión (cuya respuesta es “sí” o “no”) que pueden ser resueltos eficientemente en tiempo polinomial.
La Clase NP (Tiempo Polinomial No Determinista): Contiene a los problemas de decisión para los cuales, si bien encontrar una solución puede ser computacionalmente difícil, es posible verificar la validez de una solución propuesta (un certificado) en tiempo polinomial. Ejemplo (Satisfacibilidad Booleana - SAT): Evaluar si existe una asignación de variables lógicas que haga verdadera una fórmula booleana. Encontrar la combinación exacta puede requerir probar exponencialmente muchas opciones (), pero verificar si una asignación dada satisface la fórmula toma tiempo lineal en el tamaño de la fórmula. Por lo tanto, SAT pertenece a la clase NP.
La Cuestión y los Problemas NP-Completos
La relación entre estas clases plantea uno de los interrogantes abiertos más importantes de la ciencia de la computación: ¿Es ? Es decir: si la solución a un problema se puede verificar eficientemente, ¿se puede también encontrar de forma eficiente?
El consenso científico generalizado es que , lo que significa que verificar soluciones es fundamentalmente más sencillo que crearlas.
Dentro de la clase NP, existen problemas denominados NP-Completos. Estos problemas representan los elementos más difíciles de NP. Tienen la propiedad de que si se encontrara un algoritmo eficiente (polinomial) para resolver cualquiera de ellos, ese algoritmo podría adaptarse inmediatamente para resolver todos los problemas de la clase NP en tiempo polinomial, demostrando que .
Ejemplos clásicos:
El problema del Viajante (TSP) en su versión de decisión.
Coloreado de grafos.
Visualización de las Clases de Complejidad
Asumiendo que P ≠ NP, la relación entre estas clases se puede visualizar de la siguiente manera:
Frente a la intratabilidad de los problemas NP-Completos, en el desarrollo práctico de software se emplean algoritmos de aproximación, heurísticas o restricciones del dominio para hallar soluciones aceptables en tiempos razonables, sabiendo que una solución óptima general y rápida no es viable.
Ejemplos Detallados de Análisis
Ejemplo 1: Búsqueda del Máximo
1 2 3 4 5 6 7 8 9 10 11 12int buscar_maximo(int arr[], int n) { int max = arr[0]; // O(1) for (int i = 1; i < n; i++) { // n-1 iteraciones if (arr[i] > max) { // O(1) max = arr[i]; // O(1) } } return max; // O(1) }
Análisis:
Inicialización:
Lazo:
Complejidad total:
Optimalidad: Es óptimo porque debemos examinar todos los elementos al menos una vez para garantizar que encontramos el máximo
Ejemplo 2: Búsqueda de Duplicados
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15// Versión ingenua: O(n²) bool tiene_duplicados_ingenuo(int arr[], int n) { for (int i = 0; i < n; i++) { // n iteraciones for (int j = i + 1; j < n; j++) { // (n-i-1) iteraciones if (arr[i] == arr[j]) { return true; // O(1) } } } return false; }
Análisis:
1 2 3 4 5 6 7 8 9 10 11 12 13// Versión optimizada: O(n log n) con ordenamiento previo bool tiene_duplicados_ordenado(int arr[], int n) { qsort(arr, n, sizeof(int), comparar); // O(n log n) for (int i = 0; i < n - 1; i++) { // O(n) if (arr[i] == arr[i + 1]) { return true; } } return false; }
Análisis:
Ejemplo 3: Torres de Hanoi
1 2 3 4 5 6 7 8 9 10 11void hanoi(int n, char origen, char destino, char auxiliar) { if (n == 1) { printf("Mover disco 1 de %c a %c\n", origen, destino); return; } hanoi(n - 1, origen, auxiliar, destino); printf("Mover disco %d de %c a %c\n", n, origen, destino); hanoi(n - 1, auxiliar, destino, origen); }
Análisis mediante recurrencia: $$
$$
Solución por sustitución: $$
$$
Cuando :
Conclusión: Torres de Hanoi es inherentemente exponencial. No existe solución más eficiente.
Ejercicios de Autoevaluación
Solution to Exercise 1
Solution to Exercise 2
Utilizando la fórmula de cambio de base para logaritmos, sabemos que:
Dado que y son constantes mayores que 1, el término es una constante positiva fija.
Por definición de Big-Theta, una función si existen constantes tales que:
Si elegimos , y , se cumple la igualdad:
Lo que demuestra formalmente que . Por ende, en el análisis asintótico la base del logaritmo no afecta a la clase de complejidad y se escribe simplemente .
Solution to Exercise 3
La relación es verdadera.
Por definición, si el límite del cociente de ambas funciones tiende a cero cuando tiende a infinito:
Sustituyendo las funciones correspondientes:
Aplicando la regla de L’Hôpital (derivando numerador y denominador respecto a ):
Como el límite es 0, se cumple formalmente que , lo que significa que crece estrictamente más lento que .
Solution to Exercise 4
El orden de crecimiento asintótico de menor eficiencia (crecimiento más rápido) a mayor eficiencia (crecimiento más lento) es:
: Crecimiento factorial (inviable para ).
: Crecimiento exponencial (inviable para ).
: Crecimiento cúbico.
: Crecimiento cuadrático.
: Crecimiento log-lineal.
: Crecimiento sublineal ().
1000: Crecimiento constante ().
Solution to Exercise 5
a) (Lineal): El lazo visita cada uno de los elementos exactamente una vez.
b) (Constante): El acceso por índice calcula la dirección de memoria en tiempo fijo, independientemente del tamaño .
c) (Logarítmica): En cada iteración del lazo se descarta la mitad de los elementos restantes.
d) (Cuadrática): El lazo interno se ejecuta veces por cada iteración del lazo externo, acumulando operaciones.
Solution to Exercise 6
El tiempo de ejecución se puede modelar como para alguna constante .
Sabemos que para :
Para :
Realizamos la conversión a unidades más comprensibles:
En segundos:
En horas:
En días:
Por lo tanto, resolver el problema para tomará aproximadamente 12,4 días, lo cual ilustra la intratabilidad práctica de los algoritmos de complejidad exponencial.
Solution to Exercise 7
El lazo externo ejecuta iteraciones, con la variable tomando valores de 0 a .
Para cada iteración del lazo externo, el lazo interno se ejecuta exactamente veces (con desde 0 hasta ).
El número total de ejecuciones del cuerpo del lazo interno se calcula mediante la sumatoria: $$\sum_{i=0}^{n-1} i = 0 + 1 + 2 + \dots + (n-1) = \frac{(n-1)n}{2} = \frac{n^2
n}{2}$$
Al descartar las constantes multiplicativas y los términos de menor orden, la complejidad temporal resultante es .
Solution to Exercise 8
Lazo externo: La variable de control se triplica en cada iteración (). El lazo finaliza cuando , lo que implica que realiza iteraciones. Su complejidad es .
Lazo interno: Para cada iteración del lazo externo, este lazo se ejecuta de forma lineal exactamente veces, realizando una operación elemental de tiempo constante .
Complejidad total: Dado que los lazos están anidados de forma independiente, multiplicamos el costo de ambos:
Solution to Exercise 9
Planteamos la relación de recurrencia para el tiempo de ejecución:
Donde:
: Se realizan dos llamadas recursivas por nivel.
: El tamaño de la entrada se divide por 3 en cada llamada.
: El lazo
forrealiza iteraciones de costo constante.
Comparamos con :
Dado que y , el trabajo no recursivo en la raíz del árbol domina la complejidad.
Verificamos la condición de regularidad: para algún .
Esta desigualdad se satisface para cualquier .
Por lo tanto, aplicando el Caso 3 del Teorema Maestro, la complejidad es:
Solution to Exercise 10
Versión recursiva ingenua:
Aunque realiza un número exponencial de llamadas en total (), la pila del sistema solo almacena una rama del árbol de llamadas a la vez.
La profundidad máxima de la pila es marcos de activación. Por lo tanto, su complejidad espacial es .
Versión con memoización:
Requiere un arreglo auxiliar de tamaño para almacenar los resultados previamente computados.
La profundidad máxima de la pila de llamadas también es .
En consecuencia, consume de memoria para el arreglo de memoización y en la pila de ejecución, lo que totaliza una complejidad espacial de .
Ambas versiones requieren espacio lineal , pero la versión con memoización reduce la complejidad temporal de exponencial a lineal () a cambio de un uso explícito de memoria.
Solution to Exercise 11
Versión iterativa:
long long factorial_iterativo(int n)
{
    long long resultado = 1;
    for (int i = 2; i <= n; i++)
    {
        resultado *= i;
    }
    return resultado;
}
Esta función solo requiere almacenar las variables locales de control (
resultado,i), cuyo tamaño en memoria es constante e independiente de la entrada . Su complejidad espacial es .Versión recursiva:
long long factorial_recursivo(int n)
{
    if (n <= 1)
        return 1;
    return n * factorial_recursivo(n - 1);
}
Cada llamada recursiva introduce un nuevo marco de activación en la pila del sistema para guardar el parámetro
ny la dirección de retorno. Como se realizan llamadas recursivas anidadas consecutivas antes de alcanzar el caso base, la pila crece linealmente. Su complejidad espacial es .
Solution to Exercise 12
La matriz de tamaño tiene un total de celdas. Como el espacio crece cuadráticamente respecto al tamaño de la entrada, la complejidad espacial es .
Evaluamos la viabilidad para :
Multiplicando por el tamaño de un entero (4 bytes):
Conclusión: Esta solución es inviable en computadoras hogareñas estándar, ya que supera ampliamente la capacidad promedio de memoria RAM, provocando un desbordamiento o fallo por falta de memoria (out of memory).
Solution to Exercise 13
La clase P agrupa a los problemas de decisión que se pueden resolver de forma eficiente en tiempo polinomial (por ejemplo, determinar si un elemento pertenece a un arreglo).
La clase NP agrupa a los problemas de decisión para los cuales, dada una posible solución (certificado), se puede verificar su validez en tiempo polinomial, aunque encontrarla inicialmente pueda requerir tiempo exponencial.
El problema de factorización de enteros (dado un entero , hallar sus factores primos) es de gran interés porque:
Pertenece a la clase NP (es trivial verificar si un conjunto de factores es correcto simplemente multiplicándolos en tiempo polinomial).
No se conoce ningún algoritmo eficiente en computación clásica para resolverlo en tiempo polinomial.
No se ha demostrado que sea NP-Completo, situándose en una categoría intermedia (NP-Intermedio) bajo la hipótesis de que .
Solution to Exercise 14
Un problema es NP-Completo si cumple con dos condiciones:
Pertenece a la clase NP (es verificable en tiempo polinomial).
Es al menos tan difícil como cualquier otro problema en NP. Esto significa que cualquier problema en NP puede reducirse polinomialmente a él.
Si se encontrara un algoritmo que resolviera un único problema NP-Completo en tiempo polinomial, todos los demás problemas de la clase NP también podrían resolverse en tiempo polinomial mediante su correspondiente reducción.
Esto demostraría matemáticamente la igualdad , colapsando la jerarquía de complejidad. Tendría consecuencias masivas, rompiendo la seguridad de la criptografía moderna de clave pública y permitiendo optimizaciones óptimas inmediatas en logística y diseño de chips.
Solution to Exercise 15
Para verificar un recorrido propuesto (el certificado) en tiempo polinomial, se realiza el siguiente algoritmo:
Certificado: La solución propuesta consiste en una secuencia ordenada de ciudades: .
Validación de ciudades: Se verifica que la secuencia contenga exactamente todas las ciudades del problema sin repeticiones (a excepción del retorno a la primera ciudad). Esto toma tiempo.
Cálculo de distancias: Se recorre la secuencia y se suman las distancias entre elementos consecutivos de la matriz de distancias:
Dado que acceder a cada celda de la matriz toma tiempo, la sumatoria toma operaciones.
Comparación: Se comprueba si el , lo cual toma tiempo.
Dado que todos los pasos de verificación descritos se ejecutan en tiempo lineal , el problema pertenece a la clase NP.
Glosario
- Complejidad Algorítmica
- Medida del crecimiento de recursos (tiempo/espacio) respecto al tamaño de entrada.
- Notación Big-O
- Notación matemática que describe el límite superior del crecimiento de una función.
- Análisis Asintótico
- Método para describir el comportamiento de algoritmos cuando la entrada tiende a infinito.
Síntesis y Resumen
Resumen
El análisis de complejidad es fundamental para:
Predecir rendimiento: Saber si un algoritmo será viable para el tamaño de entrada esperado
Comparar algoritmos: Elegir el más eficiente para cada situación
Identificar cuellos de botella: Localizar partes del código que necesitan optimización
Establecer límites teóricos: Determinar si un algoritmo es óptimo o puede mejorarse
Puntos Clave
Guía Práctica de Decisión
Para elegir un algoritmo:
¿Cuál es el tamaño típico de entrada?
Pequeño (): Casi cualquier complejidad funciona
Mediano (): Evitar o peor
Grande (): Necesario o
¿Importa más tiempo o espacio?
Tiempo crítico: Considera usar más memoria (memoización, tablas hash)
Espacio limitado: Acepta algoritmos más lentos si usan menos memoria
¿Es un problema conocido?
Usa algoritmos estándar óptimos cuando existan
Para problemas NP-completos, considera aproximaciones o heurísticas
El análisis de complejidad no reemplaza la medición empírica, pero proporciona garantías teóricas esenciales para el diseño de software robusto y escalable.
Referencias y Lecturas de Complejidad Algorítmica
Referencias y Lecturas de Complejidad Algorítmica
Textos Fundamentales
Cormen et al. (2009). Capítulos 3 y 4: Growth of Functions y Divide-and-Conquer.
Sedgewick & Wayne (2011). Tratamiento exhaustivo del análisis de algoritmos y estructuras básicas.
Knuth (1974). Análisis matemático de algoritmos de control de flujo y su estructuración.
Recursos Complementarios
Bentley (1999). Programming Pearls. Excelente para el diseño y optimización práctica de algoritmos en el mundo real.
Bryant & O'Hallaron (2015). Capítulo 6: La jerarquía de memoria y su impacto directo en la complejidad real del hardware.
Recursos en Línea
MIT OpenCourseWare: 6.006 Introduction to Algorithms
Khan Academy: Algoritmos y Análisis Asintótico
Big-O Cheat Sheet: https://
www .bigocheatsheet .com/
- Cormen, T. H., Leiserson, C. E., Rivest, R. L., & Stein, C. (2009). Introduction to Algorithms (3rd ed.). MIT Press.
- Sedgewick, R., & Wayne, K. (2011). Algorithms (4th ed.). Addison-Wesley. https://algs4.cs.princeton.edu/
- Knuth, D. E. (1974). Structured Programming with go to Statements. ACM Computing Surveys, 6(4), 261–301. 10.1145/356635.356640
- Bentley, J. (1999). Programming Pearls (2nd ed.). Addison-Wesley.
- Bryant, R. E., & O’Hallaron, D. R. (2015). Computer Systems: A Programmer’s Perspective (3rd ed.). Pearson.