Recursión de Cola y Divide y Vencerás
TCO, optimización de la pila y algoritmos de división recursiva en C
Ventajas y Desventajas
Prerrequisitos: caso base, paso recursivo, stack frame y complejidad temporal/espacial. Este capítulo extiende la recursividad introductoria.
Objetivo: distinguir recursión de cola de divide y vencerás y no depender de una optimización del compilador para garantizar la terminación.
Comprobación de salida: justificá si una llamada es de cola y describí el costo de stack sin asumir TCO.
Introducción
Desarrollo
Recursión de Cola (Tail Recursion) y Optimización TCO
Una llamada recursiva se considera recursiva de cola (tail recursive) si la llamada a sí misma es la última instrucción ejecutada por la función antes de retornar, y su resultado se devuelve directamente sin realizar ninguna operación aritmética o lógica adicional.
Por ejemplo, la función factorial tradicional expuesta en el apunte
introductorio no es recursiva de cola porque, tras el retorno de
factorial(n - 1), la función debe realizar la multiplicación por n.
Podemos reescribir la función factorial para que sea recursiva de cola utilizando un acumulador:
1 2 3 4 5 6 7 8 9 10 11 12 13long int factorial_tail_rec(int n, long int acumulador) { if (n < 0) { return -1; } if (n == 0) { return acumulador; } // La llamada recursiva es la última operación física. return factorial_tail_rec(n - 1, n * acumulador); }
Optimización por parte del compilador (TCO)
Cuando una llamada es recursiva de cola, los compiladores modernos pueden aplicar una optimización llamada Tail Call Optimization (TCO). En lugar de empujar un nuevo marco de pila al call stack, el compilador sobrescribe el marco de pila de la función actual y reutiliza sus registros y variables locales, transformando efectivamente la recursión en un salto incondicional (equivalente a un lazo de control). Esto reduce la complejidad espacial auxiliar del algoritmo de a .
A continuación se presenta una tabla comparativa sobre el uso de recursos entre ambas aproximaciones:
Table 1:Comparación de recursos: Iteración vs. Recursividad
| Aspecto | Iteración (Lazos) | Recursividad |
|---|---|---|
| Uso de Memoria en el Stack | constante. El mismo marco de pila se reutiliza durante todo el lazo. | donde es la profundidad máxima de llamadas (salvo TCO exitoso). |
| Rendimiento | Más rápido. Evita la sobrecarga de llamadas y retornos de función. | Más lento por la constante asignación y liberación de marcos de pila. |
| Límite de Ejecución | Limitado solo por el tiempo de procesamiento o valores numéricos. | Físicamente limitado por el tamaño máximo del stack del sistema. |
Paradigma de Divide y Vencerás
El paradigma de “Divide y Conquista” (Divide and Conquer) es una potente estrategia para el diseño de algoritmos que consiste en resolver un problema complejo descomponiéndolo en subproblemas más pequeños y manejables. Este paradigma aplica naturalmente la recursividad para su implementación. El proceso se puede resumir en tres fases principales:
Dividir: Se descompone el problema principal en un número de subproblemas que son instancias más pequeñas del mismo problema.
Conquistar: Se resuelven los subproblemas de forma recursiva. Si un subproblema es lo suficientemente pequeño (caso base), se resuelve de manera directa.
Combinar: Se combinan las soluciones de los subproblemas para construir la solución del problema original.
Este flujo de trabajo de divide y vencerás se puede visualizar de manera gráfica en el algoritmo de ordenamiento Merge Sort:
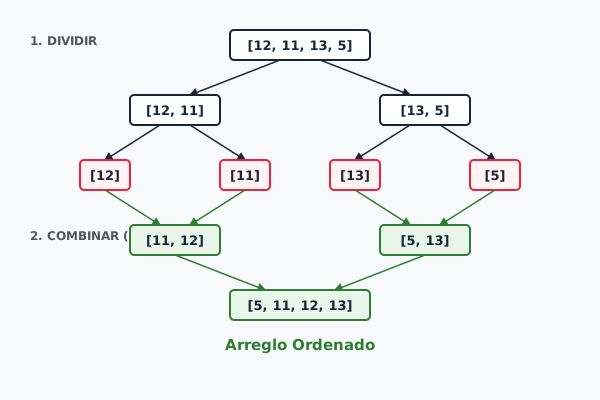
Figure 1:Paradigma de Divide y Vencerás aplicado a la ordenación del arreglo [12, 11, 13, 5] mediante Merge Sort.
Ejemplo 1: Búsqueda Binaria
La búsqueda binaria es un algoritmo altamente eficiente para localizar un elemento dentro de un arreglo ordenado. Se basa en el paradigma de divide y conquista.
Sin embargo, a menudo se enseña implementado mediante recursividad, lo cual es ineficiente desde la perspectiva del uso de memoria en sistemas reales.
Fase de División: Se compara el elemento buscado con el valor central del subarreglo. El espacio de búsqueda se reduce a la mitad.
Fase de Conquista: Si hay coincidencia, se retorna la posición. De lo contrario, se realiza una llamada recursiva sobre el subarreglo izquierdo o derecho. El caso base ocurre cuando el subarreglo está vacío (índices cruzados).
Fase de Combinación: Es trivial, ya que el resultado encontrado se propaga directamente hacia arriba en la pila.
Justificación del Consumo de Pila y Complejidad Espacial
En la versión recursiva, cada paso de división genera un nuevo marco de pila. Como el espacio se reduce a la mitad en cada paso, la profundidad máxima de la pila es de . Por ende, consume un espacio auxiliar de marcos de pila en el stack del sistema.
En contraste, la versión iterativa clásica resuelve el mismo problema utilizando
un único lazo de control while y variables locales reescritas, requiriendo un
espacio espacial auxiliar de (constante) de manera óptima, lo que elimina
cualquier riesgo de stack overflow.
Implementaciones en C
Para cumplir con la regla de uso de variables de tipo size_t en índices y
tamaños (regla 0x3010h: Las variables que representan tamaños o índices de arreglos deben ser de tipo size_t), debemos prever y evitar el desbordamiento por
decremento bajo cero (ya que size_t es un tipo de dato sin signo). Además,
declaramos el arreglo de entrada como const dado que la función no modifica
sus elementos (regla 0x3007h: Los argumentos de tipo puntero deben ser const siempre que la función no los modifique).
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64#include <stddef.h> #include <stdio.h> // Búsqueda binaria recursiva int buscar_binario_recursivo(const int arr[], size_t l, size_t r, int x, size_t *indice_encontrado) { if (l <= r) { size_t mid = l + (r - l) / 2; if (arr[mid] == x) { *indice_encontrado = mid; return 1; } if (arr[mid] > x) { if (mid > 0) { return buscar_binario_recursivo(arr, l, mid - 1, x, indice_encontrado); } } else { return buscar_binario_recursivo(arr, mid + 1, r, x, indice_encontrado); } } return 0; // Caso base: no encontrado } // Búsqueda binaria iterativa (espacio O(1) óptimo) int buscar_binario_iterativo(const int arr[], size_t size, int x, size_t *indice_encontrado) { if (size == 0) { return 0; } size_t l = 0; size_t r = size - 1; while (l <= r) { size_t mid = l + (r - l) / 2; if (arr[mid] == x) { *indice_encontrado = mid; return 1; } if (arr[mid] > x) { if (mid == 0) { break; // Evita el desbordamiento inferior de size_t al // decrementar } r = mid - 1; } else { l = mid + 1; } } return 0; }
Ejemplo 2: Ordenamiento por Fusión (Merge Sort)
Merge Sort representa una aplicación más compleja del paradigma de divide y vencerás que involucra recursión múltiple (dos llamadas recursivas) y una fase de combinación no trivial (la fusión de arreglos ordenados).
Dividir: Se divide el arreglo de elementos en dos subarreglos de tamaño cada uno.
Conquistar: Se ordena cada subarreglo de forma recursiva. El caso base es un arreglo de longitud menor o igual a 1, que ya se encuentra ordenado.
Combinar: Se fusionan (merge) los dos subarreglos ya ordenados para producir el arreglo final ordenado.
Este flujo no lineal de llamadas se puede visualizar detalladamente en la siguiente traza de ejecución:
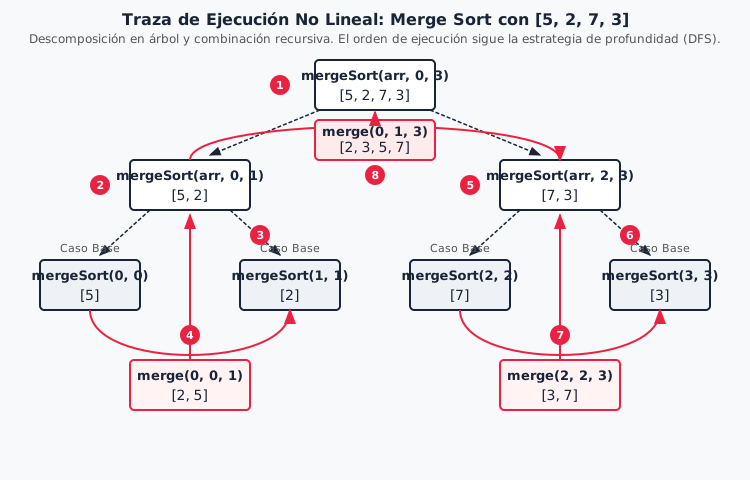
Figure 2:Árbol de llamadas recursivas y secuencia de fusión para Merge Sort con el arreglo inicial [5, 2, 7, 3]. Los números en los círculos indican el orden cronológico de ejecución (DFS).
Deficiencia del malloc en recursión profunda y optimización de buffer único
Implementación Optimizada en C
A continuación se expone la implementación correcta de Merge Sort. En
concordancia con las reglas de estilo de la cátedra, todos los bloques y
estructuras de control emplean llaves obligatoriamente (regla 0x1001h: Todas las estructuras de control deben utilizar llaves) y
los tamaños e índices se definen utilizando el tipo size_t (regla
0x3010h: Las variables que representan tamaños o índices de arreglos deben ser de tipo size_t).
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68#include <stdio.h> #include <stdlib.h> // Combina dos mitades ordenadas arr[l..m] y arr[m+1..r] utilizando el búfer // auxiliar único aux[] void fusionar(int arr[], size_t l, size_t m, size_t r, int aux[]) { size_t i = l; size_t j = m + 1; size_t k = l; for (size_t idx = l; idx <= r; idx++) { aux[idx] = arr[idx]; } while ((i <= m) && (j <= r)) { if (aux[i] <= aux[j]) { arr[k] = aux[i]; i++; } else { arr[k] = aux[j]; j++; } k++; } while (i <= m) { arr[k] = aux[i]; i++; k++; } while (j <= r) { arr[k] = aux[j]; j++; k++; } } // Función recursiva interna void merge_sort_recursivo(int arr[], size_t l, size_t r, int aux[]) { if (l < r) { size_t m = l + (r - l) / 2; merge_sort_recursivo(arr, l, m, aux); merge_sort_recursivo(arr, m + 1, r, aux); fusionar(arr, l, m, r, aux); } } // Función envolvente que preasigna el búfer auxiliar único int ordenar_merge_sort(int arr[], size_t size) { if (size <= 1) { return 0; // Ya ordenado } int *aux = (int *)malloc(size * sizeof(*aux)); // Validar asignación de memoria dinámica (regla {ref}`0x3001h`) if (aux == NULL) { return -1; } merge_sort_recursivo(arr, 0, size - 1, aux); free(aux); return 0; }
Ventajas y Desventajas
Ventajas | Desventajas |
|---|---|
Permite resolver problemas complejos de manera eficiente (por ejemplo, con complejidad ). | La sobrecarga de la recursividad (llamadas a funciones y uso de la pila) puede hacer que sea más lento que un enfoque iterativo para problemas pequeños. |
Los algoritmos son naturalmente paralelizables, ya que los subproblemas son independientes. | Puede ser más complejo de implementar correctamente que las soluciones iterativas. |
El código puede ser más elegante y fácil de entender, ya que refleja la estructura matemática del problema. | La recursividad profunda puede llevar a un desbordamiento de la pila (stack overflow) si no se maneja con cuidado. |
Ejercicios de Autoevaluación
Solution to Exercise 1
Siguiendo las reglas de estilo de la cátedra, el arreglo se declara como const
(0x3007h: Los argumentos de tipo puntero deben ser const siempre que la función no los modifique) y el tamaño size utiliza el tipo size_t (0x3010h: Las variables que representan tamaños o índices de arreglos deben ser de tipo size_t):
1 2 3 4 5 6 7 8 9 10 11 12#include <stddef.h> int sumar_arreglo_cola(const int arr[], size_t size, int acumulador) { // Caso Base: no quedan elementos por procesar if (size == 0) { return acumulador; } // Paso Recursivo de cola: sumamos el primer elemento al acumulador, // desplazamos el puntero del arreglo y decrementamos el tamaño return sumar_arreglo_cola(arr + 1, size - 1, acumulador + arr[0]); }
Dado que la llamada recursiva es la última instrucción ejecutada y su valor de retorno no se ve afectado por operaciones aritméticas pendientes, los compiladores modernos pueden reutilizar el mismo marco de pila (TCO) reduciendo el uso de stack de a .
Solution to Exercise 2
Para resolver este ejercicio con recursión de cola, los acumuladores a y b
representarán los dos números consecutivos de Fibonacci y en
cada llamada:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19#include <stddef.h> // Para calcular F(n), la función debe invocarse inicialmente como: // fibonacci_cola(n, 0, 1) unsigned long fibonacci_cola(size_t n, unsigned long a, unsigned long b) { // Caso Base 1: n == 0 retorna el primer acumulador if (n == 0) { return a; } // Caso Base 2: n == 1 retorna el segundo acumulador if (n == 1) { return b; } // Paso recursivo de cola: decrementamos n, el acumulador 'a' pasa a ser // 'b' y el acumulador 'b' toma el valor de la suma acumulada 'a + b' return fibonacci_cola(n - 1, b, a + b); }
Al ser recursiva de cola pura y estar libre de operaciones pendientes tras la invocación recursiva, el compilador puede optimizar esta función reemplazando el marco en pila, logrando un espacio constante de pila.
Solution to Exercise 3
Para estructurar la recursión de cola, implementamos un acumulador que registre la cantidad de dígitos procesados en cada paso recursivo:
1 2 3 4 5 6 7 8 9 10 11 12 13#include <stddef.h> // La función envolvente debe invocarla inicialmente con acumulador = 0 size_t contar_digitos_cola(unsigned long n, size_t acumulador) { // Caso Base: si el número es menor a 10, sumamos el último dígito y // retornamos if (n < 10) { return acumulador + 1; } // Paso Recursivo de cola: dividimos el número y sumamos 1 al acumulador return contar_digitos_cola(n / 10, acumulador + 1); }
Solution to Exercise 4
De acuerdo a las reglas de estilo, el arreglo es const (0x3007h: Los argumentos de tipo puntero deben ser const siempre que la función no los modifique) y los
índices son de tipo size_t (0x3010h: Las variables que representan tamaños o índices de arreglos deben ser de tipo size_t):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19#include <stddef.h> int maximo_divide_y_venceras(const int arr[], size_t ini, size_t fin) { if (ini == fin) { return arr[ini]; } size_t mid = ini + (fin - ini) / 2; int max_izq = maximo_divide_y_venceras(arr, ini, mid); int max_der = maximo_divide_y_venceras(arr, mid + 1, fin); if (max_izq > max_der) { return max_izq; } else { return max_der; } }
Solution to Exercise 5
El algoritmo divide el arreglo en dos mitades hasta llegar a elementos individuales:
1 2 3 4 5 6 7 8 9 10 11#include <stddef.h> long int sumar_divide_y_venceras(const int arr[], size_t ini, size_t fin) { if (ini == fin) { return arr[ini]; } size_t mid = ini + (fin - ini) / 2; return sumar_divide_y_venceras(arr, ini, mid) + sumar_divide_y_venceras(arr, mid + 1, fin); }
La profundidad máxima del call stack es debido a la división binaria del espacio.
Solution to Exercise 6
La función evalúa los elementos individuales en las hojas de la recursión y acumula las cantidades en el paso de combinación:
1 2 3 4 5 6 7 8 9 10 11 12#include <stddef.h> size_t contar_pares_divide_y_venceras(const int arr[], size_t ini, size_t fin) { if (ini == fin) { return (arr[ini] % 2 == 0) ? 1 : 0; } size_t mid = ini + (fin - ini) / 2; size_t pares_izq = contar_pares_divide_y_venceras(arr, ini, mid); size_t pares_der = contar_pares_divide_y_venceras(arr, mid + 1, fin); return pares_izq + pares_der; }
Glosario
Recursividad: Técnica donde una función se invoca a sí misma para resolver subproblemas más pequeños.
Caso Base: Condición que detiene la recursión.
Caso Recursivo: Paso donde el problema se reduce y la función se vuelve a invocar.
Síntesis y Resumen
En este apunte se han presentado los conceptos fundamentales del tema.
Referencias y Lecturas Complementarias
No se especifican lecturas complementarias para este tema.